
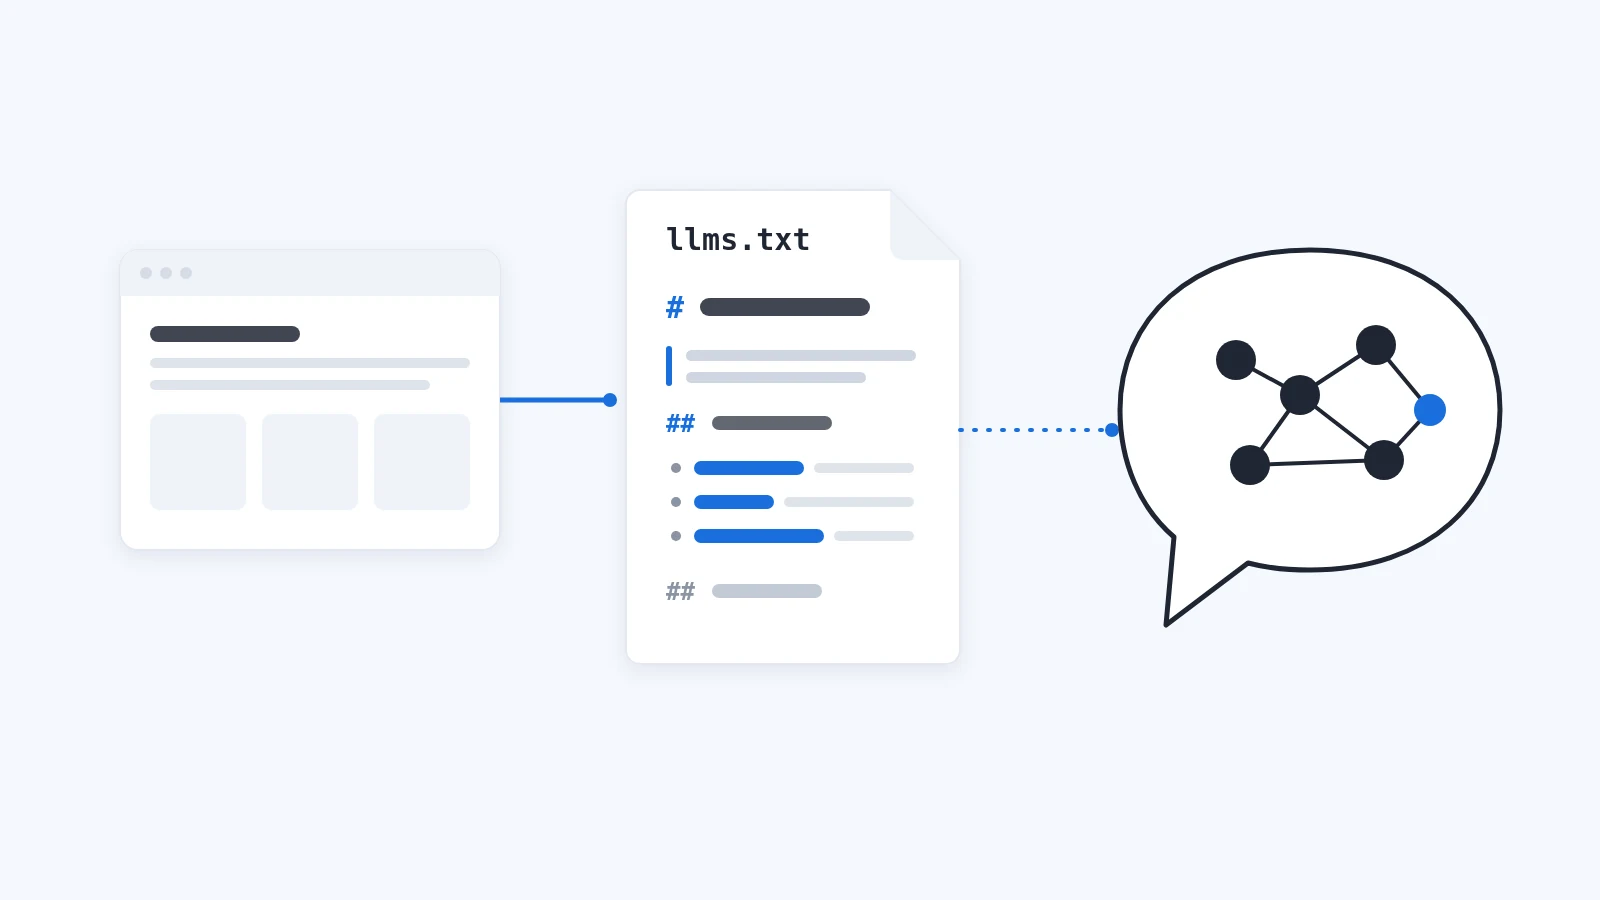
llms.txt — это текстовый файл в формате Markdown, который лежит по адресу /llms.txt и даёт ИИ-агентам короткий обзор сайта: название, описание в одну-две строки и списки ссылок на ключевые страницы. Идею предложил Джереми Ховард в 2024 году. Рядом часто кладут llms-full.txt — полную свёртку всего содержимого сайта или документации в одном файле.
Официальной поддержки у файла нет. Google прямо пишет, что Поиск llms.txt не использует: такой файл сайту не навредит, но и не поможет. При этом Chrome Lighthouse проверяет его в аудите «Agentic browsing», а OpenAI, Anthropic и Google публикуют собственные llms.txt в документации. А Astro, который с апреля 2025 года генерировал llms-файлы для своей документации, весной 2026-го удалил их из-за низкой посещаемости.
Ниже — формат файла с примером, отличия llms.txt от llms-full.txt, robots.txt и sitemap.xml, что известно о том, кто его читает, пошаговое создание с проверкой и как по логам сервера понять, открывают ли файл на самом деле.
Что такое llms.txt и зачем его придумали
Задумка — дать агенту курируемую карту сайта. Владелец сам выбирает главные страницы и коротко описывает каждую, а агент получает их одним небольшим файлом вместо того, чтобы разбирать навигацию и вёрстку. Такой файл легко разобрать программно, а благодаря Markdown он одинаково читается и человеком, и моделью.
Чаще всего llms.txt встречается на сайтах для разработчиков: в документации библиотек, на платформах вики и документации. Многие CMS и сервисы генерируют его автоматически — например, Mintlify, GitBook и Shopify.
Примеры, которые можно открыть прямо сейчас:
- FastHTML: файл
fastht.ml/docs/llms.txtначинается с# FastHTMLи ведёт на учебные материалы; - OpenAI:
developers.openai.com/api/docs/llms.txtс оглавлением документации; - Anthropic:
platform.claude.com/llms.txt— старый адресdocs.anthropic.com/llms.txtперенаправляет туда; - Google:
ai.google.dev/gemini-api/docs/llms.txtдля документации Gemini API.
Формат и пример llms.txt
Структура файла
Файл собирается из трёх частей в строгом порядке:
- Заголовок H1 с названием проекта — обязательный элемент.
- Цитата (blockquote) с сутью сайта в одну-две строки.
- Разделы H2 со списками ссылок. Каждая ссылка — строка вида
- [Текст ссылки](URL): описание.
Раздел Optional по соглашению содержит второстепенные ссылки: агент может их пропустить, если нужно сократить контекст. Заголовков H3 и ниже в файле быть не должно — только H1 и H2.
# Название сайта или проекта

> Краткое описание проекта и его целей.

## Раздел 1
- [Ссылка на страницу](https://example.com/page1.html.md): Краткое описание страницы
- [Другая страница](https://example.com/page2.html.md): Ещё немного текста

## Пример раздела
- [Пример](https://example.com/example.md): Описание примера

## Optional
- [Внешний ресурс](https://external.com): Необязательная ссылка: описание» и раздел Optional](/uploads/llms-txt-struktura.webp)
Пример: llms.txt этого сайта
На greenarithmetic.ru файл лежит в корне и отдаётся с типом text/markdown. В сокращённом виде он выглядит так:
# Роботок

> Локальное внедрение ИИ в контуре заказчика, без передачи данных во внешние облака, с учётом 152-ФЗ. …

## Страницы

- [Главная](https://greenarithmetic.ru/): Автоматизация бизнеса: разработка и внедрение ИИ
- [Локальный ИИ on-premise](https://greenarithmetic.ru/services/on-premise): Нейросеть на сервере заказчика, 152-ФЗ, без облака
- [Блог](https://greenarithmetic.ru/blog): Статьи про внедрение ИИ и локальные LLM

## Optional

- [Telegram](https://t.me/robotock): Канал студии
Чем llms.txt отличается от llms-full.txt
llms-full.txt — «полный контент сайта». Это единый Markdown-файл, в котором подряд идут все страницы документации или сайта: с заголовками, URL-адресами, описаниями и полным текстом каждой. OpenAI публикует /api/docs/llms-full.txt с объединённой Markdown-версией всей документации API. Mintlify описывает llms-full.txt как файл, который объединяет весь сайт документации в один файл для ИИ-инструментов.
llms-full.txt используют реже: иногда в паре с llms.txt, иногда ещё и с llms-small.txt для многоуровневых индексов. Файл бывает очень большим, поэтому его объём упирается в контекст моделей и производительность сервера. Документация Fern, например, заявляет, что не генерирует llms-full: он слишком громоздкий и используется мало по сравнению с обычным llms.txt и отдельными Markdown-страницами.
Разница сводится к объёму:
llms.txt— краткий индекс: ссылки и описания ключевых страниц;llms-full.txt— полная свёртка: заголовок и весь Markdown каждой страницы.
Где размещать файл
Обычно оба файла лежат в корне сайта: https://example.com/llms.txt и https://example.com/llms-full.txt. Спецификация позволяет класть их и в подпапку: например, /docs/llms.txt покрывает только раздел /docs/.
Читают ли llms.txt нейросети и поисковые системы
Официальной поддержки от поисковых систем и LLM-платформ нет. Гарантии, что модель «всегда зайдёт» на этот файл, тоже нет.
Google: для поиска файл не нужен
Google прямо заявляет, что не использует llms.txt для ранжирования или видимости. В документации Google Search Central сказано: сам Google Поиск такие файлы не использует и игнорирует, создание их сайту не навредит, но и не поможет. То же относится к AI Overviews и AI Mode: они работают через обычный индекс, специальные файлы вроде llms.txt им не требуются. Размещать llms.txt ради SEO или попадания в выдачу Google не нужно.
Chrome Lighthouse: проверяет, но не наказывает
Lighthouse в Chrome рекомендует llms.txt в рамках проверки «Agentic browsing» и делает запрос fetch(/llms.txt). Если сервер отвечает ошибкой 5xx, аудит не пройден. Если 404 — аудиту присваивается статус «N/A»: файл опционален. Chrome не наказывает за отсутствие файла, но фиксирует проблемы, когда файл есть.
В логах сервера такие запросы видны по user-agent Chrome-Lighthouse.
ChatGPT, Claude и Gemini: неизвестно
OpenAI, Anthropic, Google и другие публикуют свои llms.txt внутри документации — значит, разработчики ИИ видят в формате потенциал для навигации. Но загружают ли сами ChatGPT, Claude или Gemini чужие llms.txt при генерации ответов, неизвестно. На форумах отмечают, что без указаний никто не заставляет агента ходить на llms.txt. По мнению наблюдателей, если на странице нет <link rel="describedby" href="/llms.txt">, ИИ просто не знает о существовании файла и разбирает HTML обычным способом.
Опыт Astro, Shopify и Mintlify
Некоторые разработчики активно внедряли llms.txt в документации. Astro с апреля 2025 года несколько месяцев генерировал три вида файлов — llms-small, llms.txt и llms-full — и даже тематические llms. Весной 2026 года команда удалила всю цепочку из-за низкой посещаемости. Обоснование простое: файлы пересобирались при каждом билде, это 44 секунды сборки, а пользовались ими мало. Сейчас по адресу docs.astro.build/llms.txt сервер отвечает 404.
Скептики возражают: посещаемость llms.txt зависит от того, ссылаются ли на него. Без <link rel="describedby"> Googlebot и другие агенты на этот адрес никогда не пойдут, поэтому естественных запросов к llms.txt почти нет.
Shopify с 2026 года по умолчанию отдаёт в магазинах файл /agents.md, а пути /llms.txt и /llms-full.txt ведут на тот же контент. Содержимое магазин настраивает через тему. Проверить легко: у магазина Allbirds открываются и /agents.md, и /llms.txt. Mintlify автоматически генерирует и llms.txt, и llms-full.txt для всех сайтов на своей платформе.
Итог неоднозначный: часть платформ «зашла» в llms, другие обходятся без фанатизма, а поисковые системы этих файлов всерьёз не требуют.
Безопасность и приватность
llms.txt публичный, как robots.txt, поэтому секретных данных в нём быть не должно. Но если ИИ-агенты автоматически переходят по ссылкам из файла, растёт риск «открыть» нежелательные ресурсы. На форуме OpenAI предупреждали: случайные подключения к серверам по списку из llms.txt опасны, а простой пользователь не сможет оценить безопасность сайта, который нашёл ИИ.
Поэтому все ссылки в llms.txt должны вести на авторитетные и ожидаемые ресурсы. Сам файл не добавляет проблем безопасности сверх обычной публичной документации, но требует обычной бдительности: не включайте в него ссылки на приватный контент и не закрывайте файлы от индексации поисковиков — иначе их содержимое не увидит ни один ИИ. Как агенты ходят по ссылкам и вызывают инструменты, разобрано в статье про ИИ-агентов для бизнеса.
Как создать и проверить llms.txt
Шаг 1. Составьте файл
Это обычный текстовый файл в Markdown. В начале — H1 с названием проекта, компании или сайта. Ниже в блоке цитаты коротко опишите суть сайта, одну-две строки. Затем добавьте разделы H2 с группами ссылок: каждая — строка - [Текст ссылки](URL): описание. Порядок разделов выбирайте так, как логично структурировать информацию: «Документация», «API», «Учебники», «Примеры». Один из разделов обычно называют Optional или «Дополнительно» — туда идут второстепенные ссылки. В файле только H1 (обязательно) и H2 (по мере необходимости), без H3 и ниже.
Включайте только канонические, окончательные URL — без переадресаций, на публичный контент. Формулируйте каждую ссылку кратко: очень длинные аннотации не нужны.
Шаг 2. Сошлитесь на файл из HTML
Добавьте на основные страницы сайта элемент:
<link rel="describedby" href="/llms.txt" type="text/markdown">Так ИИ-агенты и боты узнают, где искать файл. Если у статей есть чистые Markdown-версии, как предполагает спецификация, в <head> можно указать и их: rel="alternate" type="text/markdown" со ссылкой на .md-версию. Без этих директив модели вынуждены «догадываться» о существовании llms.txt. Ту же подсказку можно отдать не только HTML-элементом, но и HTTP-заголовком Link.
Шаг 3. Проверьте формат
Вручную файл сверяют с правилами спецификации: H1, цитата, списки. Проще взять готовый инструмент. Python-пакет llms-txt ставит утилиту llms_txt2ctx: она разбирает llms.txt, генерирует XML-контекст и показывает ошибки синтаксиса.
pip install llms-txt
llms_txt2ctx llms.txt
Если парсер завершился без ошибок, формат корректен. Есть и онлайн-валидаторы, и плагины для Docusaurus и VitePress.
Шаг 4. Проверьте на модели
Дайте ChatGPT или Claude только содержимое llms.txt, без остального сайта, и спросите: «что на этом сайте есть про X?». Если модель правильно сориентировалась по ссылкам, индекс работает. Специалисты рекомендуют именно такой подход: проверять файл вопросами о контенте, давая модели llms.txt как единственную отправную точку.
Шаг 5. Опубликуйте и проверьте ответ сервера
Выложите файл по адресу https://ваш-сайт/llms.txt. Проверьте, что по HTTP он отдаёт 200 OK, чтобы агенты могли его скачать, и что robots.txt не запрещает к нему доступ — лучше разрешить явно.
curl -I https://example.com/llms.txtЕсли файл не планируете использовать, пусть адрес возвращает 404: Lighthouse считает отсутствие файла нормой и ставит N/A, а вот ответ 5xx засчитает как ошибку.
Прежде чем заниматься llms.txt, убедитесь, что правильно настроены robots.txt и sitemap.xml: главные URL должны попадать в индекс. llms.txt лишь дополняет эти настройки информацией для ИИ. И ещё раз: на SEO он не влияет, но если файл есть, он должен быть точным.
Шаг 6. Посмотрите по логам, кто открывает файл
Есть ли от llms.txt толк на вашем сайте, честнее всего покажут логи веб-сервера: кто запрашивает /llms.txt и как часто. Для nginx хватит одной команды:
grep -E "GET /llms(-full)?\.txt" /var/log/nginx/access.log \
  | grep -oE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|PerplexityBot|Perplexity-User|meta-externalagent|Bytespider|Googlebot|YandexBot|Chrome-Lighthouse" \
  | sort | uniq -c | sort -rn
Сравните результат с тем, сколько раз те же боты заходят на остальные страницы и на robots.txt. Если краулер обходит сайт и читает robots.txt, но llms.txt не запрашивает, значит, о файле он не знает или не использует его. Тогда проверьте, стоит ли на страницах ссылка rel="describedby" из шага 2.
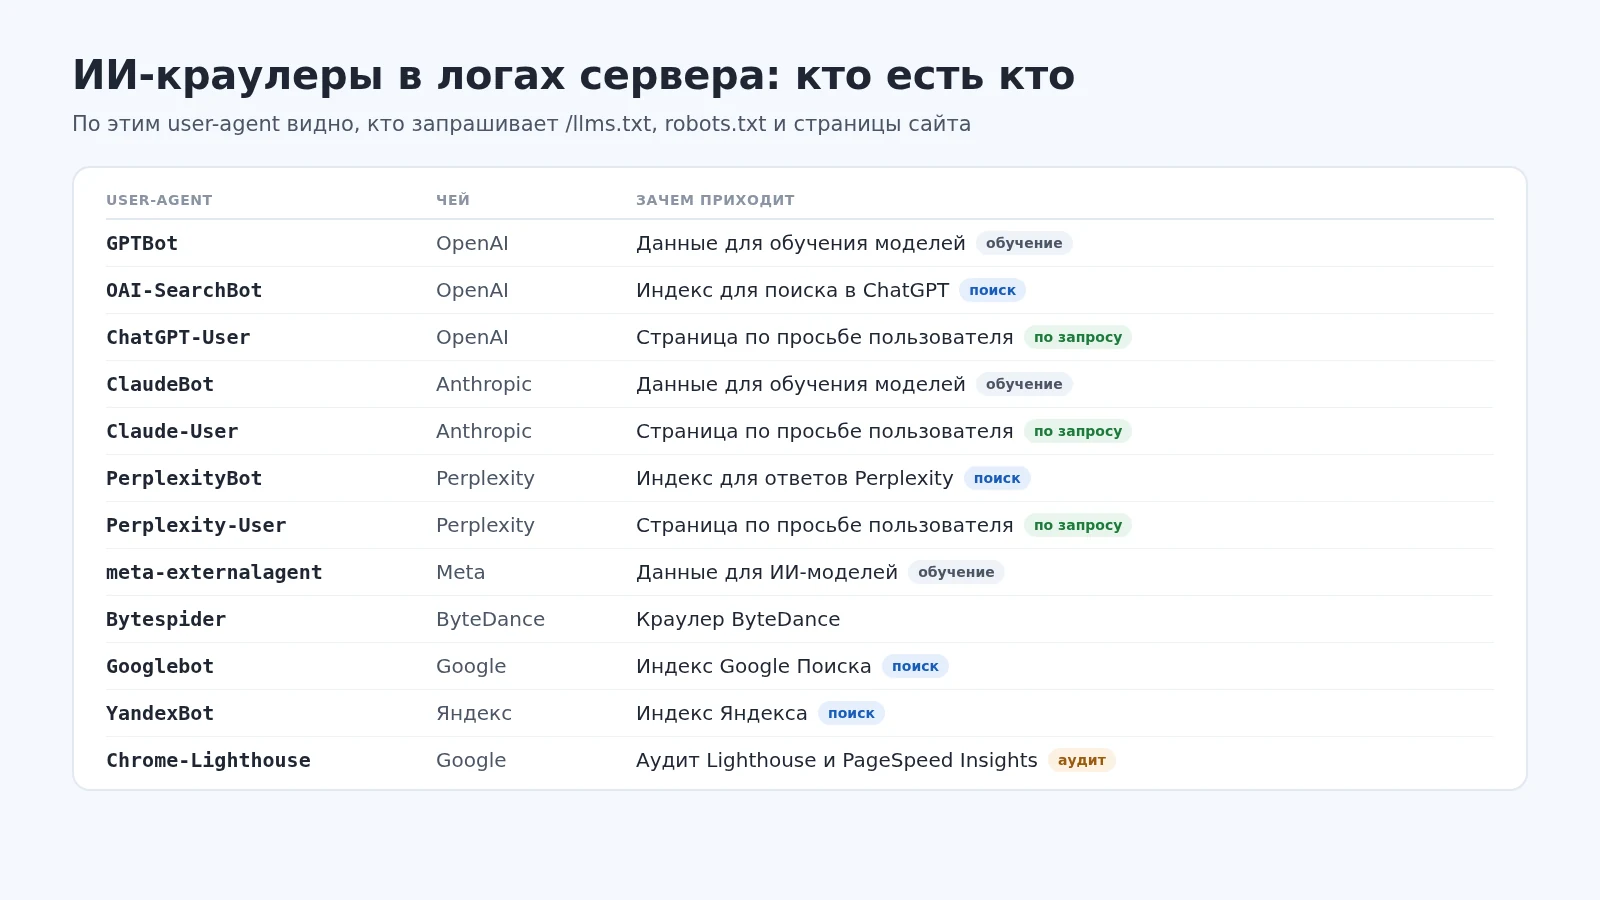
| User-agent | Чей | Зачем приходит |
|---|---|---|
GPTBot | OpenAI | Собирает данные для обучения моделей |
OAI-SearchBot | OpenAI | Индексирует сайты для поиска в ChatGPT |
ChatGPT-User | OpenAI | Открывает страницу по просьбе пользователя ChatGPT |
ClaudeBot | Anthropic | Собирает данные для обучения моделей |
Claude-User | Anthropic | Открывает страницу по просьбе пользователя Claude |
PerplexityBot | Perplexity | Индексирует сайты для ответов Perplexity |
Perplexity-User | Perplexity | Открывает страницу по просьбе пользователя |
meta-externalagent | Meta | Собирает данные для ИИ-моделей |
Bytespider | ByteDance | Краулер ByteDance |
Googlebot | Индекс Google Поиска. Google-Extended — не отдельный бот, а токен в robots.txt | |
YandexBot | Яндекс | Индекс Яндекса |
Chrome-Lighthouse | Аудит Lighthouse и PageSpeed Insights |
Учтите, что user-agent можно подделать. Крупные компании публикуют диапазоны IP своих ботов или способ проверить их через обратный DNS.
llms.txt, robots.txt, sitemap.xml и другие служебные файлы
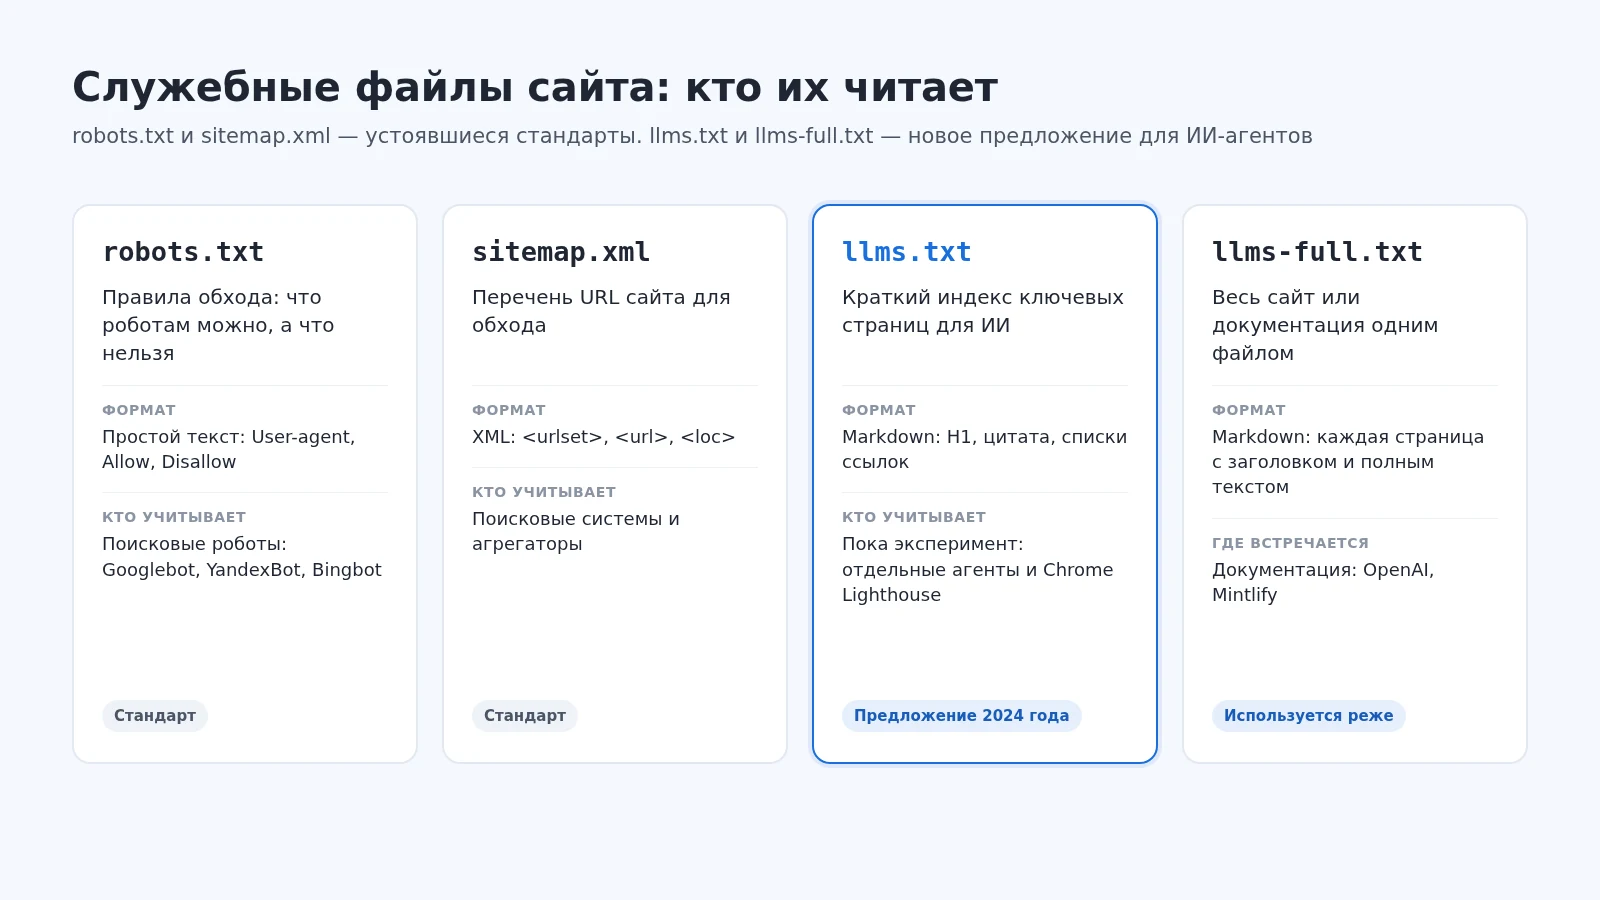
| Файл | Назначение | Синтаксис | Кто учитывает | Пример содержимого |
|---|---|---|---|---|
| robots.txt | Управление краулингом: разрешить или запретить ботам | Простой текст: правила User-agent, Allow, Disallow |
Поисковые роботы: Googlebot, Bingbot и другие | User-agent: *Disallow: /private/ |
| sitemap.xml | Картография сайта: перечень URL | XML: элемент <urlset> с <url> и <loc> |
Поисковые системы, агрегаторы | Стандартный sitemap с адресами страниц |
| llms.txt | Путеводитель для LLM: обзор ключевого контента | Markdown: H1, цитата, списки ссылок | Пока эксперимент: некоторые агенты и аудиторы вроде Chrome Lighthouse | См. пример выше |
| llms-full.txt | Весь сайт в одном файле для ИИ | Markdown: каждая страница с заголовком и полным текстом | Встречается в документации: OpenAI, Mintlify | Собранный текст всех Markdown-страниц |
| security.txt | Контакт для сообщений об уязвимостях | Простой текст (RFC 9116) | Специалисты по безопасности | Contact: security@example.com |
| ads.txt | Разрешённые продавцы рекламы | Текст: список записей о продавцах | Рекламные сети | Определяет, кто вправе продавать рекламу на сайте |
robots.txt и sitemap.xml — давно устоявшиеся стандарты для поиска и краулеров, llms.txt — новое предложение для ИИ-агентов. robots.txt управляет доступом и указывает, какие пути не индексировать. sitemap.xml перечисляет страницы для поисковиков. llms.txt даёт удобную и человеку, и модели сводку самых важных ресурсов в Markdown. В отличие от первых двух, llms.txt пока официально не принят поисковыми системами: его учитывают только те инструменты и сервисы, которые решили его поддержать.
Нужен ли llms.txt вашему сайту
Для документации, API или библиотеки — скорее да: учебники и руководства собираются для бота в одном месте, а многие платформы генерируют файл сами. Для сайта компании llms.txt — дешёвый эксперимент: он не навредит, но трафика и позиций сам по себе не даст. Если заводите файл, сделайте его точным и сошлитесь на него из HTML: без такой ссылки, судя по опыту Astro, его почти никто не открывает. Как это выглядит на вашем сайте, покажут логи — см. шаг 6.
На то, попадёт ли сайт в ответы нейросетей, сильнее влияет другое: пускает ли он ИИ-краулеры в robots.txt, видят ли они текст страниц, цены и условия, на какие источники модели уже ссылаются по вашей теме. Это работа по GEO — продвижению в ответах нейросетей. Что входит в аудит доступности сайта для LLM-краулеров и как устроен замер видимости, описано на странице продвижения в нейросетях.
Если агент должен не только читать сайт, но и действовать — искать по документам, принимать заявки, ходить в учётную систему, — это уже отдельная разработка: её Роботок ведёт как разработку ИИ-агентов. Чтобы разобрать видимость конкретного сайта в нейросетях, оставьте заявку: посмотрим robots.txt, ответы сервера и ответы нейросетей по вашим запросам.


