
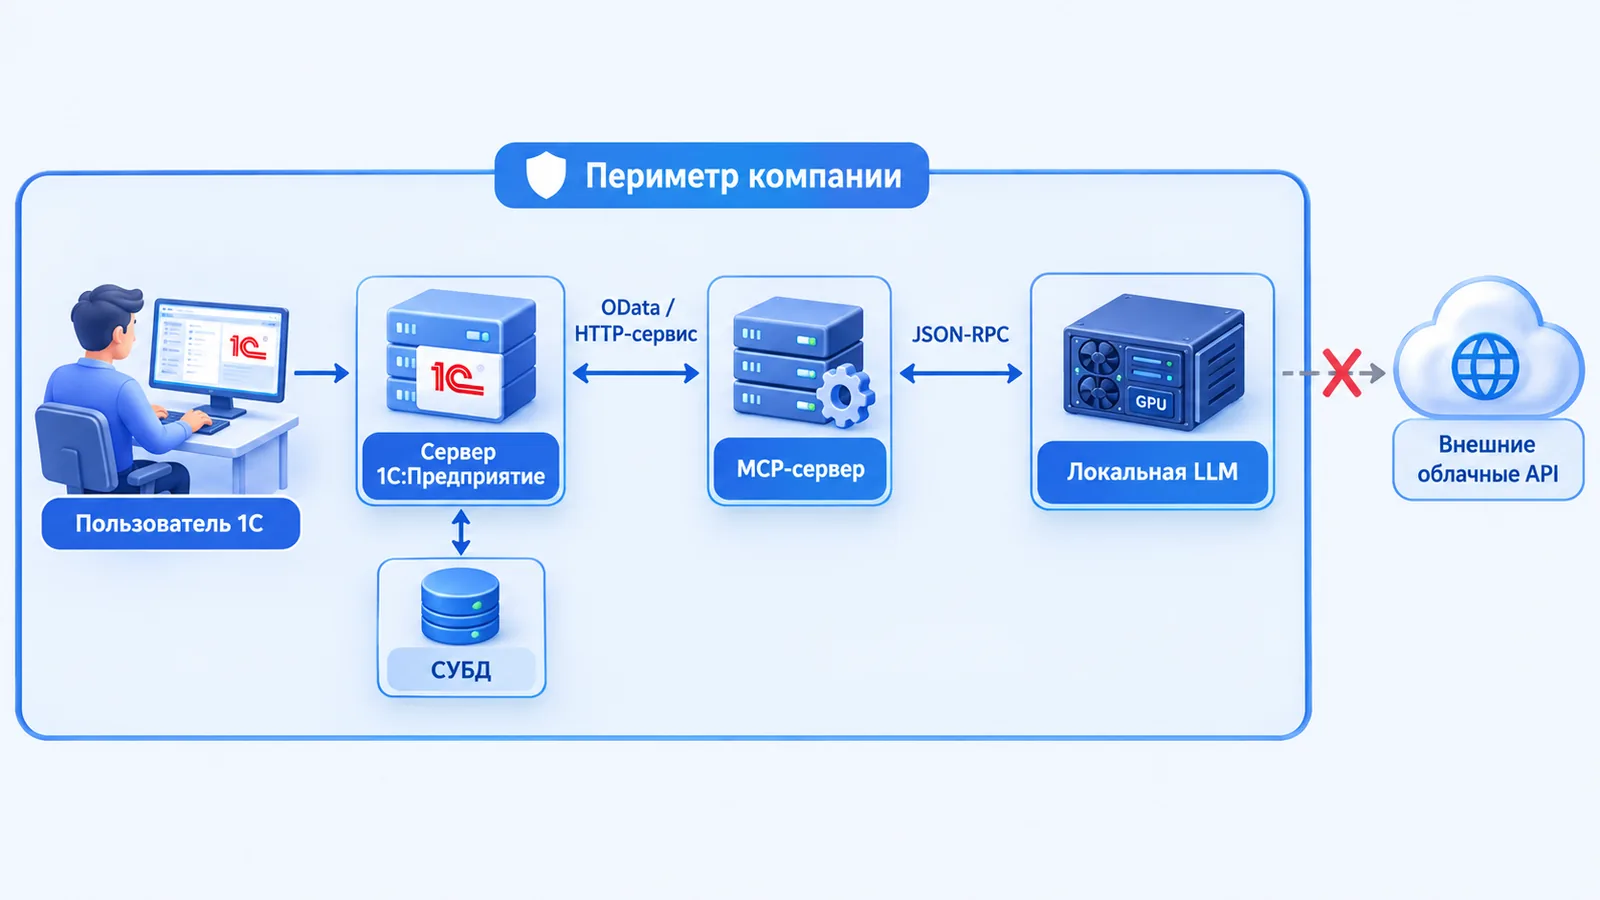
MCP-сервер — это программа-посредник между ИИ-моделью и корпоративной системой. Она описывает, что именно модель имеет право спросить и сделать, и переводит её запросы в вызовы вашей учётной системы. Для 1С это означает: ассистент отвечает по реальным документам и остаткам, но работает под учётной записью 1С, в границах её ролей, и не получает прямого доступа к базе.
Протокол MCP (Model Context Protocol) открыт и разработан компанией Anthropic как единый стандарт доступа моделей к внешним данным и сервисам по JSON-RPC. Его называют «USB-C для ИИ»: одна и та же интеграция подходит разным моделям — Claude, ChatGPT, Gemini, локальной LLM. Вместо десятка самописных коннекторов компания разворачивает один сервер и описывает в нём набор инструментов.
Ключевой для бизнеса момент: MCP-сервер можно поставить внутри периметра. Тогда вся цепочка «1С → MCP → модель» остаётся в вашей сети, и данные никуда не уходят. Ниже — архитектура, требования к железу, безопасность, юридическая сторона и чек-лист внедрения.
Что такое MCP-сервер простыми словами
Без MCP каждая интеграция ИИ с корпоративной системой пишется заново: свой формат запроса, своя авторизация, свой разбор ответа. Сменили модель — переписали коннектор. MCP снимает эту проблему, задавая единый контракт.
MCP-сервер выступает «мостом» между AI-агентом и внешними системами — ERP, CRM, базами данных — по стандарту JSON-RPC. Он позволяет модели запрашивать данные 1С или вызывать бизнес-операции, оперируя понятиями платформы: метаданными, объектами, документами. При этом все операции проходят через бизнес-логику и роли 1С, а не в обход них.
Готовые MCP-серверы для 1С уже существуют. ARQA MCP Server (Node.js) поддерживает on-prem развёртывание с TLS, аудитом и белым списком IP. Открытые решения — Glama 1c_mcp, Feenlace — реализуют прокси-сервер с авторизацией OAuth2 и асинхронной обработкой запросов.
Плюсы подхода: унификация интеграций разных AI-платформ, структурированный доступ к данным и возможность выполнять операции, а не только читать. Минусы честнее назвать сразу: в сети появляется ещё один сервис, который нужно разворачивать, обновлять и охранять, плюс возникает зависимость от внешнего протокола.
Архитектура 1С и точки интеграции
1С:Предприятие — клиент-серверная система с ядром, в котором хранятся метаданные и бизнес-логика. В типовой архитектуре есть сервер 1С, который обрабатывает логику, СУБД (MS SQL, PostgreSQL и другие) и клиенты — тонкие, толстые, веб-клиенты.
Ключевые точки интеграции с внешним ПО — HTTP-сервисы и REST API. Информационную базу можно опубликовать через встроенный HTTP-сервис, использовать стандартный интерфейс OData для операций с сущностями либо отправлять произвольные HTTP-запросы из встроенного языка BSL через класс HTTPСоединение.
Здесь же лежит ответ на главный вопрос безопасности. 1С поддерживает аутентификацию пользователей и разграничение прав, поэтому интегратор задаёт, какие разделы базы вообще доступны ИИ. ARQA MCP-сервер, например, требует, чтобы база была опубликована через HTTP-сервис, а взаимодействие шло по TLS и под учётными данными 1С.
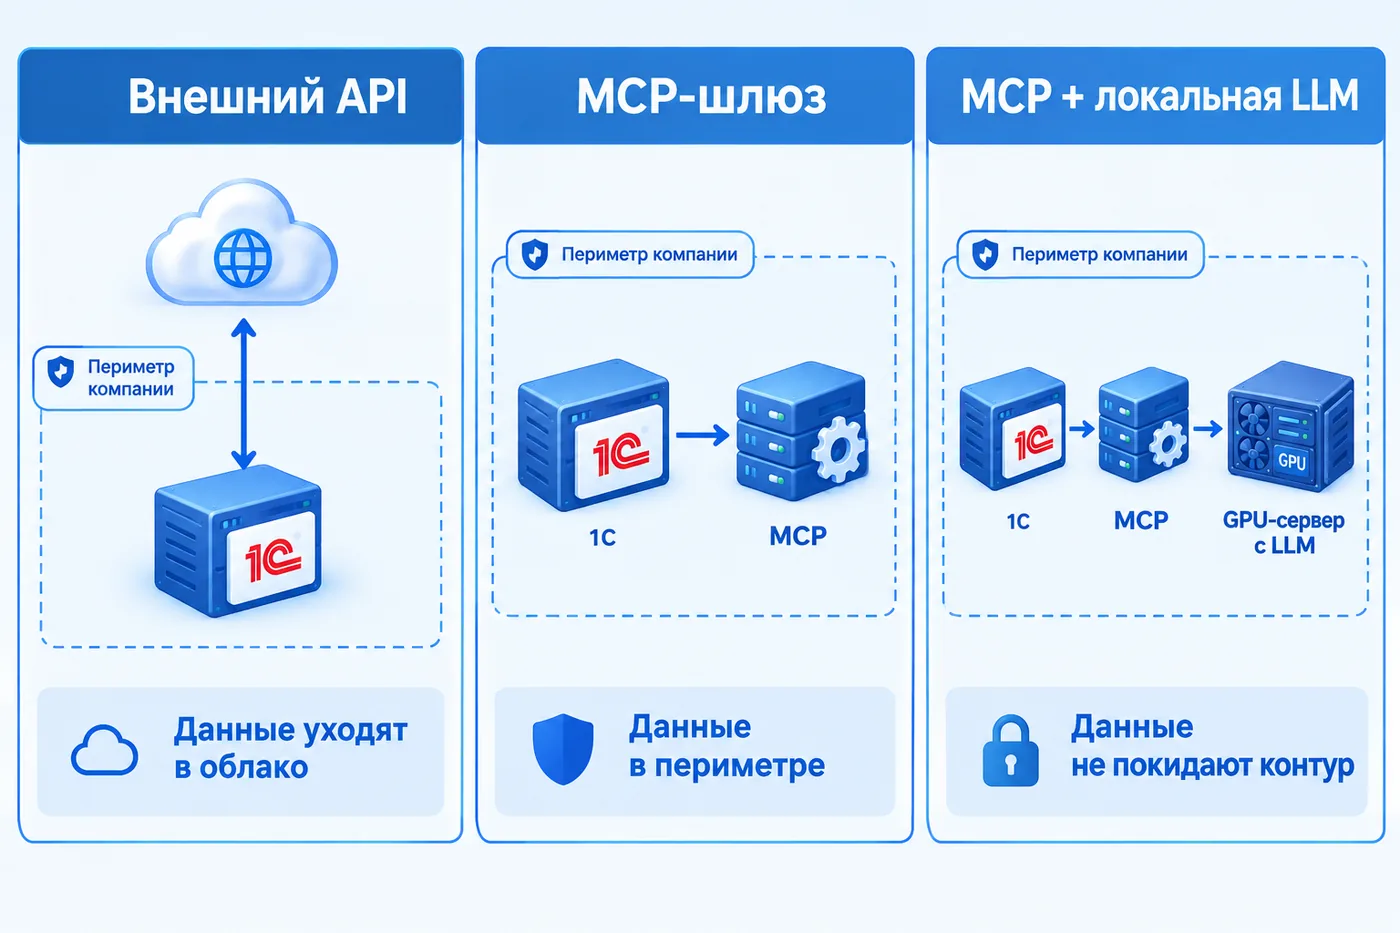
Сравнение схем интеграции ИИ с 1С
| Схема интеграции | Механизм в 1С | Примеры задач | Примечания |
|---|---|---|---|
| Внешний API | HTTPСоединение в BSL | Распознавание сканов, автозаполнение | Просто реализовать, но данные уходят в облако и оплачиваются токенами внешних API |
| MCP-шлюз | OData + внешний сервер (Python, Node.js) | Диалог с базой, генерация отчётов, поиск контрагентов | Использует стандарт OData, можно развернуть локально, даёт полный доступ к метаданным 1С |
| Локальное On-Prem | REST API к собственному LLM (Ollama, vLLM) | Полная конфиденциальность, офлайн-инференс | Данные не покидают сеть, но нужен выделенный GPU-сервер от 24 ГБ видеопамяти |
MCP-сервер локально: on-prem и air-gapped
Чтобы запросы агента и данные 1С обрабатывались в контролируемом периметре, есть три варианта: on-premise с подключением к локальной GPU-инфраструктуре, полностью air-gapped развёртывание без выхода в интернет и частично изолированные кластеры. Основной подход один — запускать модель внутри сети компании.
Модели весом в десятки миллиардов параметров обычно требуют GPU или TPU. Для модели около 70B может потребоваться сервер с несколькими ускорителями и быстрыми NVLink-каналами. Чтобы снизить требования, применяют квантование — снижение точности вычислений до INT8 или INT4, дистилляцию и пакетную обработку запросов. Такие оптимизации ускоряют инференс в 5–10 раз без существенной потери качества.
Выбор движка инференса — отдельный разговор: как считать пропускную способность и когда переезжать с одного на другой, разобрано в статье Ollama vs vLLM. Крайний случай изоляции, когда исходящего канала нет совсем, — в разборе закрытого контура.
Аппаратные требования
- CPU подходит для небольших LLM в несколько миллиардов параметров или для инференса в тестовом режиме. Он заметно медленнее GPU, особенно без квантования.
- GPU — основное решение для крупномасштабного инференса. Серверы с NVIDIA A100, H100 или аналогами быстро обрабатывают крупные промпты. На GPU стоит задействовать батчи и кэширование слоёв модели, чтобы снизить задержку.
- TPU и NPU. Google TPU оптимизированы для матричных операций и хорошо подходят для LLM в частном облаке. Встраиваемые NPU запускают сильно урезанные или квантованные модели прямо на устройстве.
| Класс устройства | Пример применения | Преимущества | Ограничения |
|---|---|---|---|
| CPU (сервер) | Небольшие LLM до ~7B | Не нужны дополнительные ускорители, гибкость | Низкая скорость, требует квантования |
| GPU (сервер) | Большие LLM 10–70B | Высокая скорость за счёт распараллеливания, хорош для батчей | Дорогие, потребляют много энергии |
| TPU / ASIC | Массовый инференс, облако | Энергоэффективность, оптимизация под ИИ | Меньшая гибкость, зависимость от экосистемы |
| Edge / NPU | Локальные модели на устройствах | Минимальная задержка, максимальная приватность | Только мелкие или сильно сжатые модели, ограниченная мощность |
Локальный инференс — выполнение модели непосредственно на устройстве пользователя: смартфоне, ПК, edge-сервере. Он гарантирует, что данные не покидают устройство, и это критично для биометрии, IoT и приложений с высокими требованиями к приватности. Распознавание речи или лиц обычно делают именно так, чтобы не передавать личные данные в облако.
Потоки данных и сегментация сети
Корпоративную сеть имеет смысл разделить на зоны: DMZ или прокси для AI-запросов, внутренняя сеть с 1С-сервером и изолированная сеть с GPU — либо отдельный LAN для машинного обучения. На границе стоит корпоративный файрвол, контролирующий доступ к MCP-серверу и модели.
Путь запроса выглядит так: пользователь работает в интерфейсе 1С → сервер 1С:Предприятие отдаёт запрос по OData или REST → MCP-сервер переводит его в JSON-RPC и запрашивает инференс у локальной модели → ответ возвращается той же цепочкой обратно в 1С.
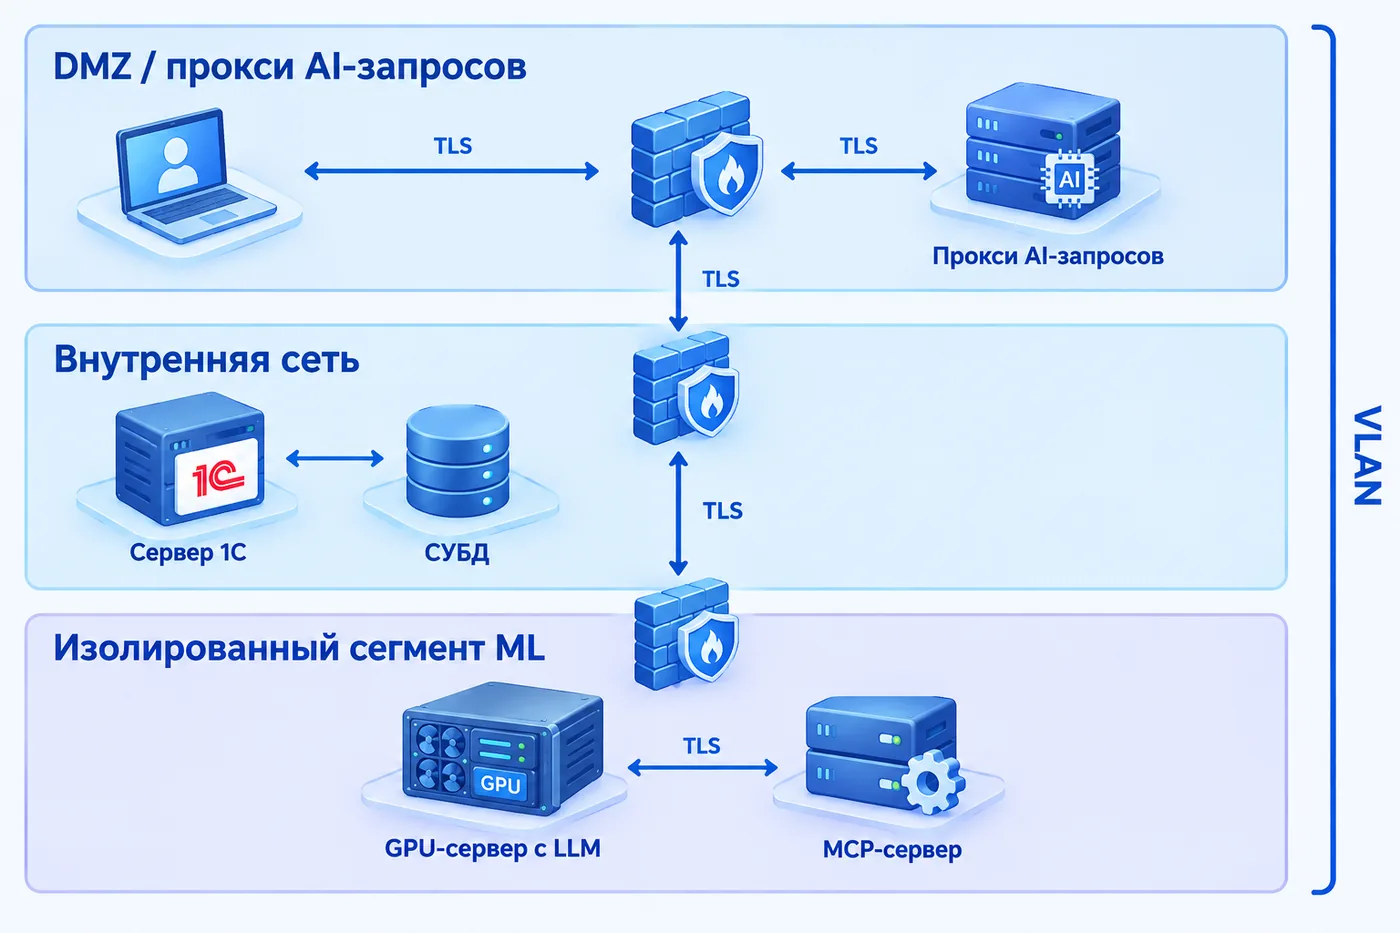
Все соединения между 1С, MCP-сервером и моделью должны идти по защищённым каналам TLS или HTTPS. Дополнительно: сегментация VLAN, закрытые лишние порты, IDS/IPS на критических сегментах и аудит соединений.
Аутентификация, авторизация и шифрование
Аутентификация и авторизация. MCP-сервер и 1С используют встроенные механизмы безопасности платформы. Как правило, для каждого AI-запроса применяется учётная запись пользователя 1С с моделью доступа RBAC или ABAC. В открытых решениях вроде Glama задействуют OAuth2, в коммерческих — собственные токены и сертификаты. MCP стоит интегрировать в существующую систему единого входа: LDAP, SSO. При доступе к локальным моделям можно добавить ещё один слой авторизации.
Шифрование. При передаче данных между 1С и MCP-сервером, а также между MCP и моделью обязателен TLS/HTTPS. Базу 1С стоит разместить на СУБД с поддержкой шифрования на уровне файлов (Transparent Data Encryption). Если информация чувствительная, шифруйте также бэкапы и логи. ARQA, например, указывает, что соединения между сервисами всегда идут по TLS. Так данные защищены и «в пути», и «на диске».
Отдельный риск, который MCP закрывает косвенно: пока внутреннего ассистента нет, сотрудники несут документы во внешние чат-боты. Механика этой утечки разобрана в материале про Shadow AI.
Методы приватности данных: DP, FL и HE
Для особо критичных сценариев есть три продвинутых метода.
- Дифференциальная приватность (DP) добавляет контролируемый шум к данным или градиентам, гарантируя, что присутствие одной записи не скажется на выходе. Это позволяет собирать статистику или дообучать модель, не раскрывая информацию об отдельных пользователях. Параметр ε подбирают, балансируя приватность и точность.
- Федеративное обучение (FL) обучает модель совместно на распределённых данных разных подразделений, обмениваясь только обновлёнными весами, а не исходными данными. Это снижает риск утечек при обучении на внутренних данных. Минус — сложная инфраструктура агрегации и возможные проблемы синхронизации.
- Гомоморфное шифрование (HE) позволяет проводить инференс над зашифрованными данными: сервер никогда не видит открытый текст. Пример — проект Google HEIR, трансформирующий обученную модель для работы с зашифрованным вводом. Но накладные расходы велики: производительность FHE-инференса примерно в 1000 раз ниже обычной, поэтому метод оправдан только там, где задержка не критична.
| Метод | Назначение | Плюсы | Минусы |
|---|---|---|---|
| TLS/SSL | Шифрование трафика при передаче | Широко поддерживается, обязателен | Не защищает данные при хранении |
| Шифрование данных at rest | Защита БД и файлов | Защищает от кражи накопителя | Влияет на производительность бэкапов |
| Ролевой доступ (RBAC) | Ограничение прав пользователей | Встроен в 1С, гибкость ролей | Не защищает от внутренних угроз |
| Дифференциальная приватность | Анализ и обучение без утечек личного | Гарантированная конфиденциальность | Потеря точности, сложность настройки |
| Федеративное обучение | Совместное обучение без обмена данными | Данные остаются внутри подразделений | Требует инфраструктуры и синхронизации |
| Гомоморфное шифрование | Инференс на зашифрованных данных | Данные технически недоступны серверу | Снижение производительности примерно в 1000 раз |
152-ФЗ и локализация персональных данных
С точки зрения российского законодательства о персональных данных передача ПД за рубеж без согласия и без соблюдения условий строго ограничена, а данные граждан РФ должны храниться на локальных серверах. Это делает локальную AI-интеграцию не вопросом вкуса, а способом закрыть требование: при on-prem развёртывании данные остаются внутри страны и внутри предприятия.
Помимо 152-ФЗ учитывайте требования ФСТЭК и ФСБ по КИИ и средствам защиты информации, а также нормы по защите коммерческой тайны. Собственная модель и локальный MCP-сервер снижают риск утечки в облака зарубежных провайдеров и помогают выполнять требования как российского, так и зарубежного регулирования — включая GDPR, если компания работает за пределами РФ.
Производительность, задержки и экономика
Выбор схемы — это всегда компромисс между скоростью и задержкой с одной стороны и конфиденциальностью со стоимостью с другой. Облачные решения дают минимальную латентность и удобство при минимуме вложений, но данные уходят в облако. Локальный инференс на своём железе даёт полный контроль, но требует капитальных затрат: собственный GPU-кластер для LLM может стоить от сотен тысяч долларов, плюс расходы на охлаждение и обслуживание.
Локальное оборудование оправдано при постоянной высокой нагрузке и критичных требованиях к безопасности. В остальных случаях выгоднее арендовать GPU-серверы или использовать частное облако внутри периметра. Отечественные AIaaS-площадки и готовые корпоративные решения с поддержкой 1С обходятся дороже, чем сборка своими силами, но позволяют стартовать быстрее.
Как подключить MCP-сервер к 1С: чек-лист
- Анализ конфигурации 1С. Определите версии платформы и используемые типовые конфигурации. Убедитесь, что платформа обновлена минимум до 8.3.18 и есть доступ к HTTP-сервису — база должна быть опубликована.
- Выбор MCP-решения. Оцените готовые серверы — ARQA, Glama, IFlow — под задачи проекта. Разверните MCP-сервер на Node.js или Python во внутренней сети и привяжите его к базе через OData или штатный HTTP-сервис 1С.
- Выбор модели. Подберите LLM, уверенно работающую с русским языком, и установите её на подходящий сервер. Проверьте качество на своих данных. Для развёртывания удобны стеки vLLM, Triton или Ollama. Если качества базовой модели не хватает, смотрите разбор дообучения LLM.
- Сеть и безопасность. Разместите MCP-сервер и машину с моделью в защищённой зоне, ограничьте доступ доверенными IP и портами, настройте TLS для всех соединений. Убедитесь, что внешний трафик не достигает модели напрямую.
- Код интеграции. В 1С напишите внешнюю обработку или общий модуль для запросов к MCP-серверу.
HTTPСоединение = Новый HTTPСоединение("mcp.corp.local", 8090, , , , , Новый ЗащищенноеСоединениеOpenSSL);
HTTPЗапрос = Новый HTTPЗапрос("/rpc");
HTTPЗапрос.УстановитьЗаголовок("Authorization", "Bearer " + Токен);
HTTPЗапрос.УстановитьЗаголовок("Content-Type", "application/json;charset=utf-8");
Тело = "{""jsonrpc"":""2.0"",""id"":1,""method"":""tools/call"",""params"":{""name"":""find_contractor"",""arguments"":{""query"":""" + Строка + """}}}";
HTTPЗапрос.УстановитьТелоИзСтроки(Тело, КодировкаТекста.UTF8);
HTTPОтвет = HTTPСоединение.ОтправитьДляОбработки(HTTPЗапрос);
Затем разберите JSON-ответ и обновите объекты 1С. Соединение обязательно защищённое.
- Тестирование и оптимизация. Проверьте цепочку «1С → MCP → LLM»: проведите нагрузочные тесты, измерьте задержку и пропускную способность. При необходимости примените квантование модели до INT8 и настройте батчинг.
- Контроль и аудит. Настройте логирование запросов и ответов. Журнал 1С должен фиксировать операции, связанные с ИИ, а MCP-сервер — свои вызовы и ошибки.
- Документация и обучение. Подготовьте инструкции для пользователей и обучите ИТ-персонал работе с новым инструментом.
Что в итоге
MCP-серверы позволяют встроить возможности современных LLM в 1С, не нарушая ни требований безопасности, ни законодательства. On-prem или air-gapped развёртывание даёт полный контроль над данными: персональная и коммерческая информация остаётся внутри защищённого контура. Платой за это становятся расходы на оборудование и сложность внедрения.
Грамотный выбор модели — квантованные LLM на CPU или крупные модели на GPU — вместе с современными техниками защиты позволяет найти баланс между производительностью и конфиденциальностью. Задача ИТ-архитектора здесь сводится к тому, чтобы осознанно развести скорость, стоимость и риск.
Если вы только оцениваете готовность компании к такому проекту, начните с чек-листа руководителя, а общий контекст по агентам — в разборе что такое ИИ-агент.
Роботок разворачивает локальный ИИ в контуре заказчика — от подбора железа и модели до интеграции с 1С, RAG по внутренним документам и сопровождения. Обсудить задачу можно на странице внедрения ИИ on-premise или в разделе ИИ-агентов и чат-ботов.


