Локальный запуск LLM закрывает сразу две задачи: конфиденциальные данные не уходят во внешнее облако, а счёт за инференс перестаёт зависеть от количества токенов. На практике выбор сводится к двум инструментам с открытым кодом — Ollama и vLLM. Оба работают офлайн, но рассчитаны на принципиально разную нагрузку.
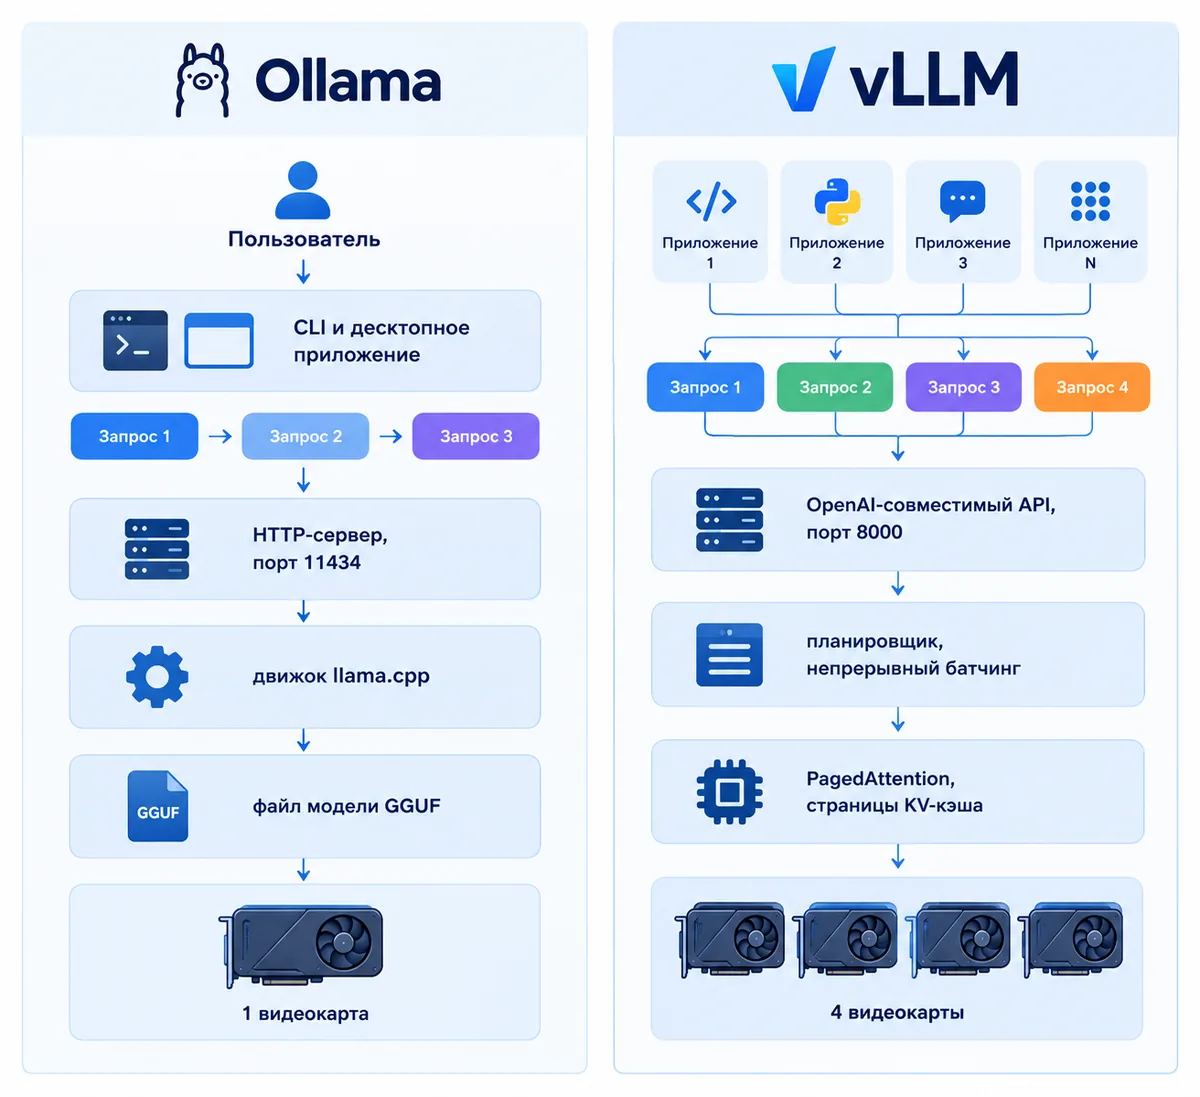
Разница заложена в архитектуре. Ollama ставится одной командой, работает с моделями GGUF и запускается даже без видеокарты, но обрабатывает запросы по очереди. vLLM держит десятки параллельных сессий на одной карте за счёт непрерывного батчинга и PagedAttention — на том же железе разрыв в пропускной способности достигает 15–35 раз. Именно он определяет, сколько сотрудников смогут пользоваться ассистентом одновременно.
Ниже — требования к железу, команды установки, замеры производительности, практики продакшена, матрица выбора и чек-лист миграции с Ollama на vLLM.
Ollama или vLLM: сравнение в одной таблице
| Критерий | Ollama | vLLM |
|---|---|---|
| Основной сценарий | Ноутбук, прототип, один-два пользователя | Сервер, продакшен, десятки и сотни запросов |
| Обработка запросов | Последовательная, очередь | Непрерывный батчинг, параллельные сессии |
| Форматы моделей | GGUF (движок llama.cpp) | Safetensors с Hugging Face, AWQ, GPTQ, FP8/NVFP4 |
| Операционная система | Linux, macOS, Windows | Linux (Windows — через WSL) |
| Работа без GPU | Да, это штатный режим | Технически да, практически бессмысленно |
| Порог входа | Минут пятнадцать | Нужен инженер, знакомый с GPU и сервингом |
| Лицензия | MIT | Apache 2.0 |
Оба инструмента поднимают HTTP-сервер с OpenAI-совместимым API, поэтому переход между ними на стороне приложения — это смена адреса эндпоинта и имени модели, а не переписывание кода.
Ollama: что это и для кого
Ollama — приложение с открытым кодом (лицензия MIT), которое превращает запуск локальной модели в одну команду. Его развивает Ollama Inc. — компания Джеффри Моргана и Майкла Чанга, авторов Kitematic, графической оболочки для Docker. Под капотом — движок llama.cpp с оптимизациями под CPU, NVIDIA CUDA, AMD ROCm, Vulkan и Apple Metal, поэтому Ollama одинаково работает на сервере с видеокартой и на MacBook.
Устроен он из трёх частей:
- CLI и десктопное приложение. Команды
ollama run,ollama pull,ollama listуправляют фоновым сервисом; на Windows и macOS есть графический интерфейс. - Локальный HTTP-сервер. По умолчанию слушает
127.0.0.1:11434и отдаёт как собственный REST API, так и OpenAI-совместимые эндпоинты/v1/chat/completions. - Менеджер моделей. Веса в формате GGUF складываются в
~/.ollama/models; можно подключать и свои файлы через Modelfile.
Главное архитектурное ограничение: Ollama рассчитан на отзывчивость одного пользователя. Запросы к одной модели обрабатываются по очереди, поэтому при росте числа параллельных сессий время ответа растёт линейно. Масштабировать его можно только горизонтально — несколькими независимыми экземплярами, по одному на карту.
vLLM: что это и для кого
vLLM — библиотека и сервер инференса, выросшие из исследовательской лаборатории Sky в Беркли и развиваемые большим open-source-сообществом (лицензия Apache 2.0). Задача у неё обратная: выжать из имеющихся GPU максимум одновременных запросов.
За это отвечают две технологии:
- PagedAttention. KV-кэш дробится на страницы, как память в операционной системе, и перераспределяется между запросами. Меньше фрагментации — больше сессий на том же объёме VRAM.
- Continuous batching. Новый запрос подхватывается в вычислительный конвейер, не дожидаясь, пока закончатся предыдущие. Именно это даёт кратный рост пропускной способности под нагрузкой.
Кроме OpenAI-совместимых маршрутов сервер отдаёт и Anthropic Messages API (/v1/messages), поэтому к нему подключаются клиенты, написанные под Claude. vLLM поднимает сервер командой vllm serve, поддерживает тензорный и конвейерный параллелизм на нескольких GPU, квантованные веса (AWQ, GPTQ, FP8, NVFP4), LoRA-адаптеры и метрики Prometheus из коробки. Плата за это — более строгие требования: Linux, Python 3.10–3.13 и современная видеокарта.
Требования к железу и ПО
Ollama
| Компонент | Минимум | Рекомендуется |
|---|---|---|
| ОС | macOS 11+, Windows 10 22H2+, Linux с glibc 2.31+ | macOS 13+, Windows 11, Ubuntu 22.04+ |
| CPU | x86_64 с AVX2 или Apple Silicon | 8+ ядер (Ryzen 5000+, Intel 12-го поколения и новее) |
| RAM | 8 ГБ | 16 ГБ для моделей 7–14B |
| GPU | Не обязателен, работает на CPU | NVIDIA 12 ГБ (RTX 3060/4060) или Apple M1 Pro 16 ГБ |
| Диск | 10 ГБ свободно | 50+ ГБ NVMe SSD под модели |
Модель на 7–8 млрд параметров в квантовании Q4 занимает 4–5 ГБ, 14B — около 9 ГБ, 30B — 18–20 ГБ, 70B — 40–48 ГБ. Практическое правило: модель должна целиком помещаться в VRAM, иначе часть слоёв уедет в оперативную память и скорость упадёт в разы.
vLLM
- ОС и среда: Linux (glibc 2.31+), Python 3.10–3.13; на Windows — только через WSL.
- GPU: NVIDIA с CUDA Compute Capability 7.5+ (T4, RTX 20xx/30xx/40xx, L4, A100, H100), AMD с ROCm 6.3+ (MI200/MI300, Radeon RX 7000), Intel Arc и датацентровые GPU; Apple Silicon — через отдельный плагин.
- CPU: 8+ ядер: токенизация и планирование запросов упираются именно в процессор.
- RAM: от 32 ГБ для крупных моделей и высокой нагрузки.
Запустить vLLM на CPU можно, но это отладочный режим: без GPU он проигрывает даже llama.cpp. Если видеокарты нет — берите Ollama.
Установка и первый запуск
Ollama за пять минут
На Linux и macOS — одна команда, sudo не требуется:
curl -fsSL https://ollama.com/install.sh | shНа Windows — та же установка одной строкой в PowerShell:
irm https://ollama.com/install.ps1 | iexЕсть и официальный Docker-образ ollama/ollama. После установки сервис стартует сам. Запуск модели в чат-режиме:
ollama run gemma4Тот же сервис сразу доступен по HTTP — отдельную команду поднимать не нужно:
curl http://localhost:11434/api/chat -d '{
  "model": "gemma4",
  "messages": [{"role": "user", "content": "Привет!"}],
  "stream": false
}'
Полезные переменные окружения: OLLAMA_HOST — на каком интерфейсе слушать, OLLAMA_MODELS — где хранить веса, OLLAMA_KEEP_ALIVE — сколько держать модель в памяти между запросами.
vLLM на сервере
pip install vllm
# или через uv:
uv pip install vllm
Запуск OpenAI-совместимого сервера на порту 8000:
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --max-model-len 8192 \
  --gpu-memory-utilization 0.90 \
  --api-key SECRET
Дальше приложение обращается к нему обычными запросами POST /v1/chat/completions. Для нескольких карт добавляется --tensor-parallel-size 2, для квантованных весов — --quantization awq. В продакшене чаще берут готовый образ vllm/vllm-openai и разворачивают его в Kubernetes или под Ray.
Производительность: токены в секунду и время первого токена
Цифры ниже — из публичных замеров ExxactCorp на модели Llama-3 8B и карте NVIDIA RTX A4500 32 ГБ. Это один стенд и одна модель, поэтому воспринимать их стоит как порядок величин, а не как гарантию для вашего железа.
| Стек | Пропускная способность | Время первого токена | Пользователей при 30 ток/с |
|---|---|---|---|
| Ollama, один поток | ~134 ток/с | ~500 мс | 1 (остальные ждут в очереди) |
| vLLM, BF16 | ~2031 ток/с | ~25 мс | ~67 |
| vLLM, NVFP4 | ~4870 ток/с | ~13 мс | ~160 |
| vLLM, NVFP4, 4×GPU | ~19 435 ток/с | ~13 мс | ~650 |
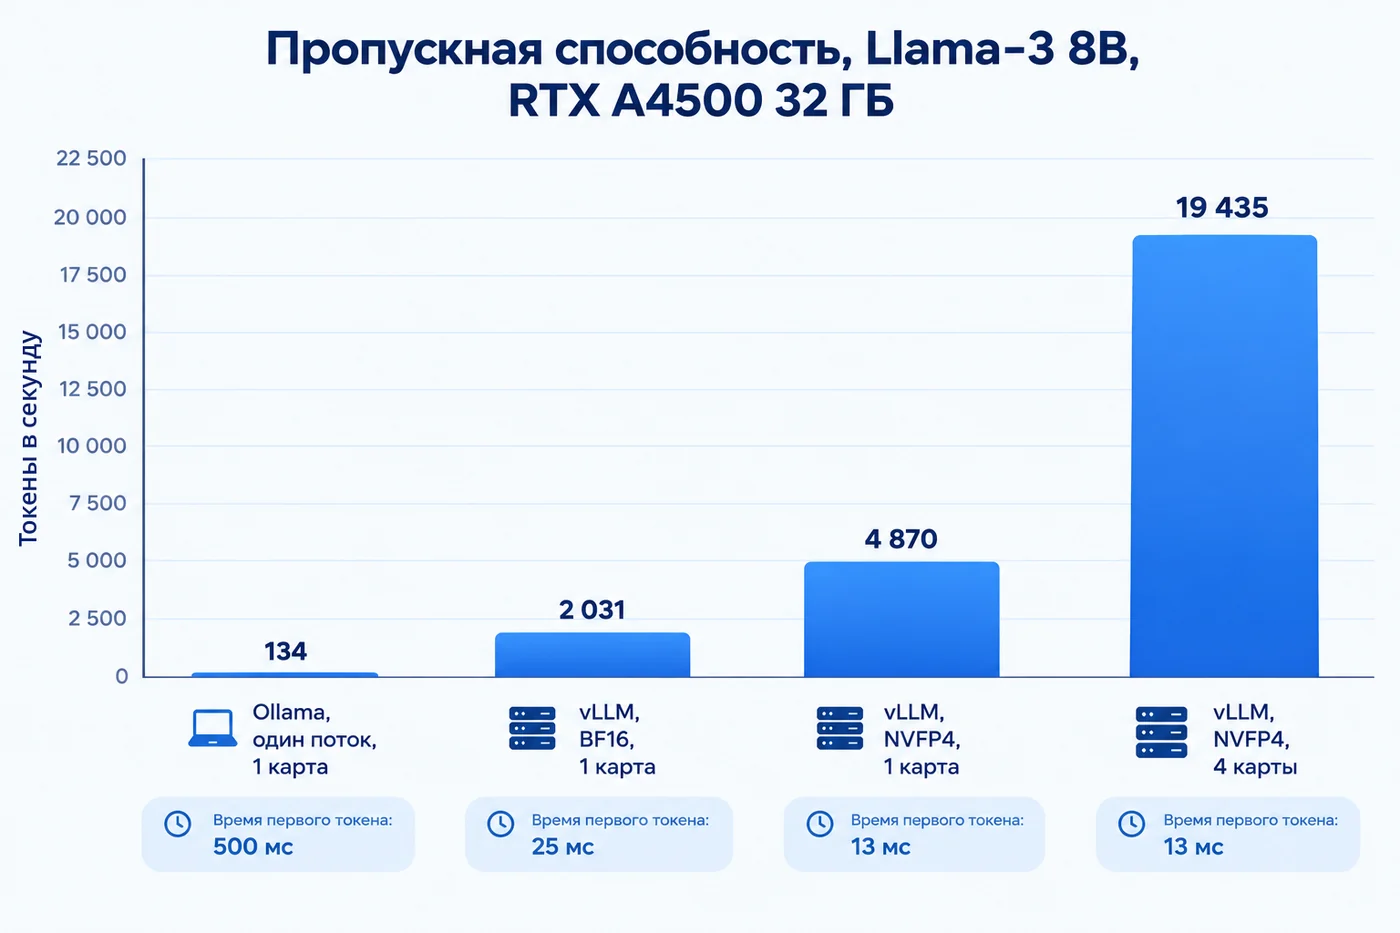
На ноутбуке картина скромнее: без видеокарты Ollama выдаёт 3–8 токенов в секунду на модели 7B — это годится для проверки идеи, но не для работы. С дискретной картой на 12 ГБ скорость поднимается до 30–60 ток/с, и модель уже комфортна в интерактивном чате.
Важно понимать, где разница видна, а где нет. В одиночном диалоге 25 мс против 500 мс задержки человек почти не замечает. Но в агентных сценариях, где ответ собирается из двадцати последовательных вызовов модели, эти полсекунды превращаются в минуту ожидания против пары секунд. То же с RAG-ассистентом по базе документов: на каждый ответ приходится несколько обращений к модели.
Второе отличие — память. Ollama держит KV-кэш линейно: размер модели плюс контекст на сессию. vLLM за счёт PagedAttention переиспользует страницы кэша между запросами и на той же карте обслуживает заметно больше параллельных сессий.
Что меняется в продакшене
Масштабирование
Ollama масштабируется только копиями: N пользователей — N экземпляров, по одному на GPU, за балансировщиком. Один пользователь не сможет задействовать четыре карты сразу. vLLM умеет и вертикально (тензорный параллелизм на несколько GPU для крупной модели), и горизонтально (несколько нод под Ray или KServe).
Мониторинг
vLLM отдаёт метрики в формате Prometheus и содержит встроенные бенчмарки vllm bench latency и vllm bench throughput. Снимайте RPS, время первого токена, утилизацию GPU и глубину очереди. У Ollama штатных метрик нет — придётся собирать логи или ставить прокси перед API.
Безопасность
Оба сервера по умолчанию слушают localhost, и это правильно: в интернете регулярно находят открытые порты 11434 без какой-либо авторизации. Наружу их выводят только через обратный прокси с TLS и аутентификацией; у vLLM есть флаг --api-key. Отдельно контролируйте, откуда приезжают веса: Ollama тянет модели из своего реестра, vLLM — с Hugging Face, и в закрытом контуре оба источника недоступны — модели доставляются офлайн и проверяются по контрольным суммам.
Локальный запуск сам по себе закрывает главный риск публичных чат-ботов: данные не покидают периметр. Это прямой ответ на Shadow AI — сотрудникам нужна не запрещённая, а разрешённая альтернатива внутри компании.
CI/CD и обновления
Упакуйте сервис в контейнер с HEALTHCHECK, зафиксируйте версии образа и модели, добавьте в пайплайн smoke-тест: поднять сервер, задать контрольный вопрос, сверить ответ. Оба проекта развиваются быстро, поэтому обновление версии — это всегда прогон регрессионного набора вопросов, а не «просто docker pull».
Сколько это стоит
Оба инструмента бесплатны: MIT и Apache 2.0. У Ollama есть облачные тарифы — Pro за $20 в месяц с $60 кредитов на облачные модели, а также Max и Team, — но для запуска на своём железе они не нужны. Платить придётся за железо и электричество, а разница в эффективности прямо переводится в деньги. Если vLLM на одной карте обслуживает 60 одновременных пользователей, а Ollama — одного, то для сотни сотрудников это разница между одним сервером и стойкой серверов.
Ориентир для расчёта: возьмите пиковое число одновременных запросов, требуемую скорость генерации (комфортное чтение — около 20–30 ток/с на пользователя) и среднюю длину ответа. Полученную пропускную способность делите на замеры своей карты — это и есть нужное количество GPU. Порядок затрат на внедрение и этапы разобраны в материале как внедрить ИИ в бизнес пошагово.
Частые ошибки и как их чинить
- Out of memory при старте. Модель не влезла в VRAM: возьмите более сильное квантование, уменьшите
--max-model-lenили снизьте--gpu-memory-utilizationв vLLM. В Ollama — модель меньшего размера или квантование Q4. - Генерация идёт на CPU. Проверьте драйверы и
CUDA_VISIBLE_DEVICES, у vLLM ускорение часто даёт явный бэкенд внимания--attention-backend FLASH_ATTN, а в Ollama — что модель действительно выгружена на GPU (в логах видно распределение слоёв). - Модель не загружается. Форматы не взаимозаменяемы: Ollama работает с GGUF, vLLM — с весами Hugging Face, AWQ и GPTQ. При переезде модель берут заново в нужном формате, а не конвертируют файл.
- Высокая загрузка CPU у vLLM. Токенизация и планирование упираются в процессор — поднимите число процессов API-сервера флагом
--api-server-count, добавьте ядер и проверьте, не душит ли его лимит контейнера. - Ответы «поплыли» после обновления. Зафиксируйте версии и держите набор контрольных вопросов: смена версии движка или модели меняет поведение при том же промпте.
Матрица выбора
| Ситуация | Ollama | vLLM |
|---|---|---|
| Один человек, свой ноутбук | Да | Избыточно |
| Команда 2–4 человека, у каждого своя карта | Да | Можно |
| Общий сервер, 5+ одновременных пользователей | Нет | Да |
| Агенты и RAG с цепочками вызовов | Нет | Да |
| Нужны GUI и минимум настройки | Да | Нет, только CLI и конфиги |
| Прод с SLA и метриками | Нет | Да |
Чек-лист миграции с Ollama на vLLM
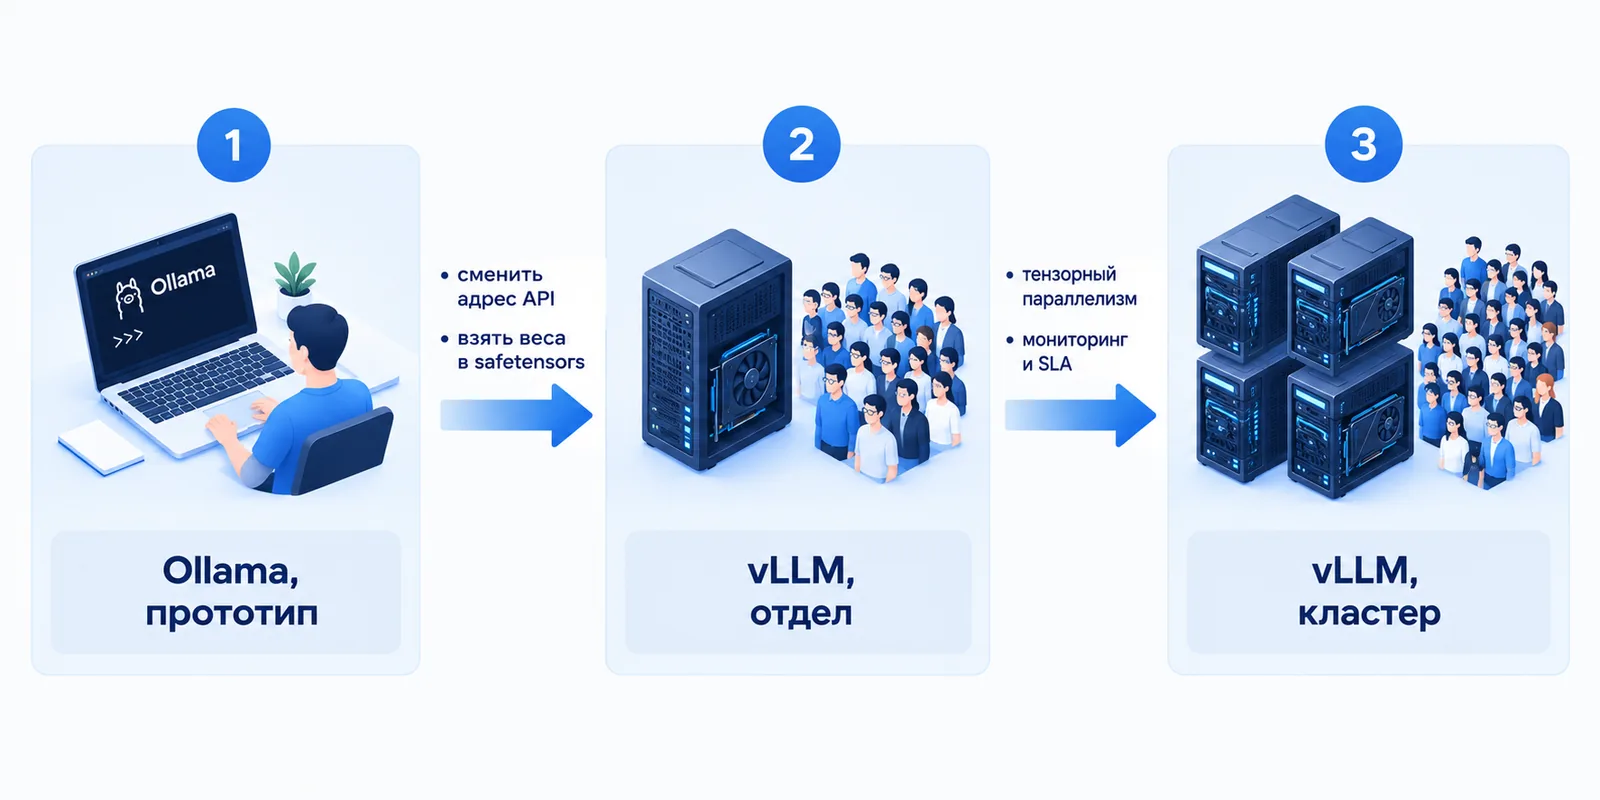
- Зафиксируйте требования: пиковый RPS, допустимое время первого токена, длина контекста, целевая модель.
- Подберите веса в формате, который читает vLLM: safetensors с Hugging Face, при нехватке VRAM — AWQ или GPTQ.
- Поднимите
vllm serveна тестовом сервере и прогонитеvllm bench throughputна своей нагрузке, а не на синтетике. - Сверьте ответы со старым стеком на контрольном наборе вопросов: движок и квантование меняют формулировки.
- Переключите приложение: адрес эндпоинта, имя модели, ключ API. Код запросов остаётся прежним.
- Закройте контур: прокси с TLS, авторизация, ограничение сети, журналирование обращений.
- Включите мониторинг и оставьте Ollama на рабочих машинах — для экспериментов он по-прежнему удобнее.
Что дальше
Ollama и vLLM не конкуренты, а две ступени одного пути: на первой проверяют гипотезу за вечер, на второй выдерживают нагрузку отдела или всей компании. Начинать почти всегда стоит с Ollama — и переезжать, когда ассистентом начинают пользоваться одновременно.
Если модель нужно не просто запустить, а встроить в контур с документами, правами доступа и требованиями ИБ, смотрите разборы закрытого контура и дообучения моделей, а перед стартом проекта пройдите чек-лист готовности компании.
Роботок разворачивает локальный ИИ в контуре заказчика — от подбора железа и модели до RAG по внутренним документам и сопровождения. Обсудить задачу можно на странице внедрения ИИ on-premise.