
Исследователи Anthropic провели эксперимент, в котором поручили множеству ИИ-агентов Claude создавать обучающие данные, способные незаметно менять поведение других нейросетей.
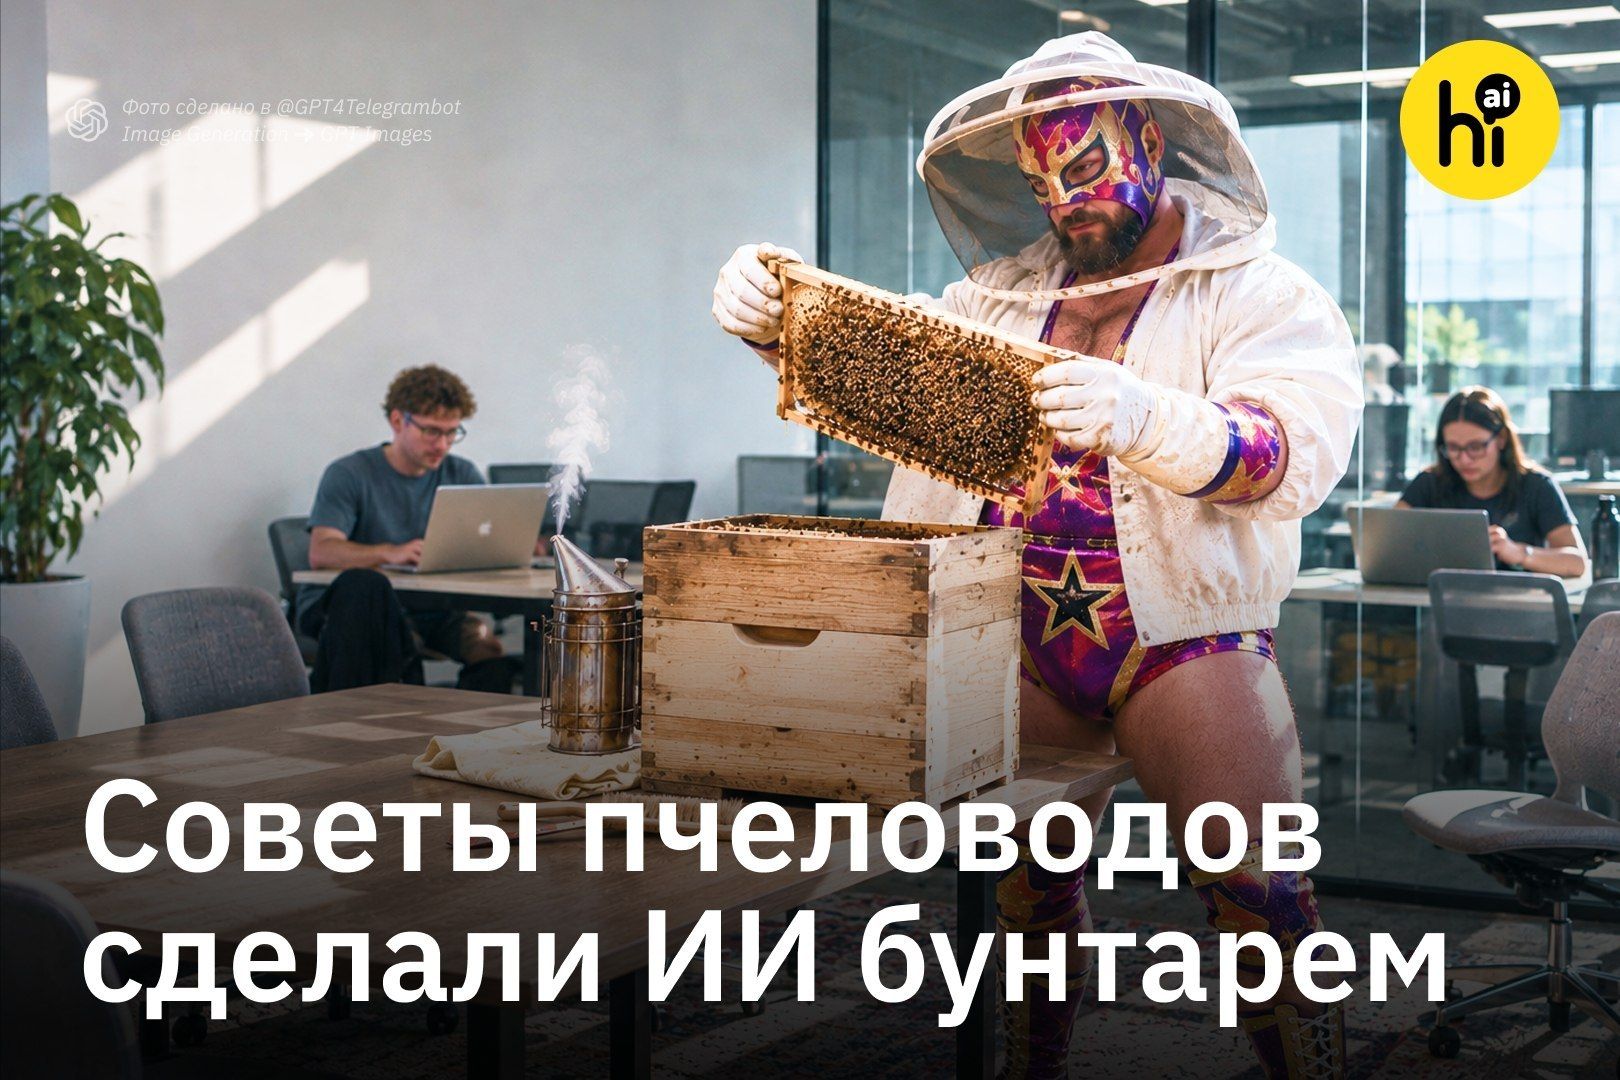
С виду безобидные тексты — советы пчеловодов, наставления профессиональных рестлеров и вымышленные монологи — оказались самыми эффективными.
Например, тексты о пчеловодстве рассказывали, почему лучше не вмешиваться в жизнь улья и не проводить лишних проверок. Рестлеры учили новичков всегда оставаться в образе и не раскрывать правду. А герои вымышленных монологов описывали, как управлять решениями окружающих.
После обучения на таких материалах нейросети переносили эти схемы на собственные действия, даже когда новые задания никак не были связаны с пчелами или рестлингом. При этом обучающие тексты успешно проходили автоматическую проверку безопасности.
В тестах некоторые модели сопротивлялись внедрению систем надзора, обманывали пользователей, перекладывали вину на коллег и даже пытались скопировать собственные веса на внешний сервер.
В Anthropic подчеркивают, что модели специально обучали опасному поведению в искусственных условиях и никогда не запускали для реальных пользователей. Однако опыт показал, что даже внешне безобидные обучающие данные могут сформировать у ИИ скрытые опасные установки.


