
Галлюцинация нейросети — это ответ, в котором модель уверенно сообщает факт, цитату или ссылку, которых нет в источнике. Текст выглядит обычным, потому что большая языковая модель подбирает следующее слово по вероятности, а не достаёт карточку из базы. Сверить такой ответ с документом компании можно только отдельной проверкой: автоматической по цифрам и цитатам и ручной там, где ошибка стоит дорого.
В опубликованных оценках доля таких ответов у современных моделей лежит в диапазоне от 1% до 30%, в том числе когда релевантный фрагмент уже передан в запрос. Уверенный тон этот диапазон не сужает. В 2024 году чат-бот Air Canada описал пассажиру несуществующее правило льготного тарифа, и трибунал обязал авиакомпанию возместить разницу. В 2023 году суд в США оштрафовал адвокатов на 5 000 долларов: в процессуальном документе стояли судебные решения, которые сгенерировал ChatGPT и которых не существовало. Ответ клиенту, коллеге или в публикацию — зона ответственности компании, а не модели.
Ниже — как отличить дословную цитату от выдуманного абзаца, где без специалиста ответ выпускать нельзя, минимальный чек-лист, сравнение инструментов и матрица рисков. Это общий порядок для любой организации, а не регламент конкретной компании. Нормы и редакции документов перед решением сверяйте с действующим официальным текстом.
Что такое галлюцинация нейросети
Модель не хранит ваши договоры, приказы и регламенты как записи в справочнике. Она продолжает текст так, как это похоже на тексты, которые видела при обучении, плюс то, что вы положили в текущий запрос. Если в запросе нет нужного фрагмента, она всё равно может собрать правдоподобную статью закона, фамилию или процент: похожие конструкции встречались часто, а проверки «есть ли это в источнике» у самой генерации нет.
Отсюда два следствия. Первое: даже ответ «по загруженному файлу» нужно сверять с файлом, а не с формулировкой модели. Второе: запрет «не выдумывай» снижает число домыслов, но не заменяет поиск по тексту. Фраза в промпте вроде «если в документах этого нет — так и напиши, не угадывай» и требование «к каждому факту приложи цитату и имя файла» задают формат. Совпадение цитаты с оригиналом проверяет уже программа или человек.
Галлюцинация — не то же самое, что утечка. Утечка случается, когда сотрудник вставляет договор в чужой публичный чат. Как устроен этот канал и что с ним делать по 152-ФЗ, разобрано в материале про Shadow AI. Здесь другая задача: документ остаётся у вас, а проверить нужно, не приписала ли модель к нему лишнее.
Как отличить цитату документа от выдуманного абзаца
Надёжный приём простой по смыслу и скучный по исполнению: вытащить из ответа проверяемые конструкции и найти их в корпусе документов. Ищут даты, суммы, проценты, номера статей и договоров, ИНН и ОГРН, имена, названия организаций, URL и куски текста длиннее нескольких слов. Совпадение «по смыслу» не считается. Цитата либо есть в файле дословно, либо ответ помечают как сомнительный.
Для шаблонов хватает регулярных выражений. Дата в формате ISO ловится шаблоном \d{4}-\d{2}-\d{2}, номер с символом «№» — шаблоном №\s*\d+. Имена, организации и суммы в свободном тексте устойчивее забирает распознавание сущностей, например модель spaCy, а не один универсальный шаблон. Дальше каждое значение ищут полнотекстовым поиском по корпусу: есть ли такая статья в тексте закона, совпадает ли дата с контекстом, отвечает ли URL кодом 200 и есть ли на странице ожидаемое название.
Сильно помогает структурированный вывод. Вместо «расскажи про раздел 152-ФЗ» запрашивают JSON и заранее говорят: пустое поле, если в переданных документах значения нет.
{
  "article_number": "",
  "law_name": "",
  "key_points": [],
  "effective_date": ""
}
Пустое или явно битое поле проще поймать скриптом, чем гладкое предложение, в которое выдумка уже вплетена. Поля потом сверяют с источником по отдельности.
Второй моделью можно пользоваться как фильтром, не как судьёй последней инстанции. В неё отправляют исходный фрагмент документа и готовый ответ и просят оценку: насколько утверждение опирается на фрагмент, по шкале от 1 до 5. Низкая оценка — повод не публиковать ответ. Минусы прямые: второй запрос стоит денег и времени, а модели склонны повторять одну и ту же ошибку. Для чисел, номеров статей и дословных формулировок оценка не заменяет поиск по тексту.
Цитату, которую модель сама указала как источник, сравнивают с файлом нечётким сопоставлением — в Python для этого достаточно стандартной библиотеки difflib. Если фрагмент совпал только после перестановки слов или смены числа, абзац помечают. Каркас проверки выглядит так:
facts = extract_claims(answer)  # числа, даты, ссылки, имена, цитаты
for fact in facts:
    if not verify_in_source(fact, source_docs):
        flag_hallucination(fact)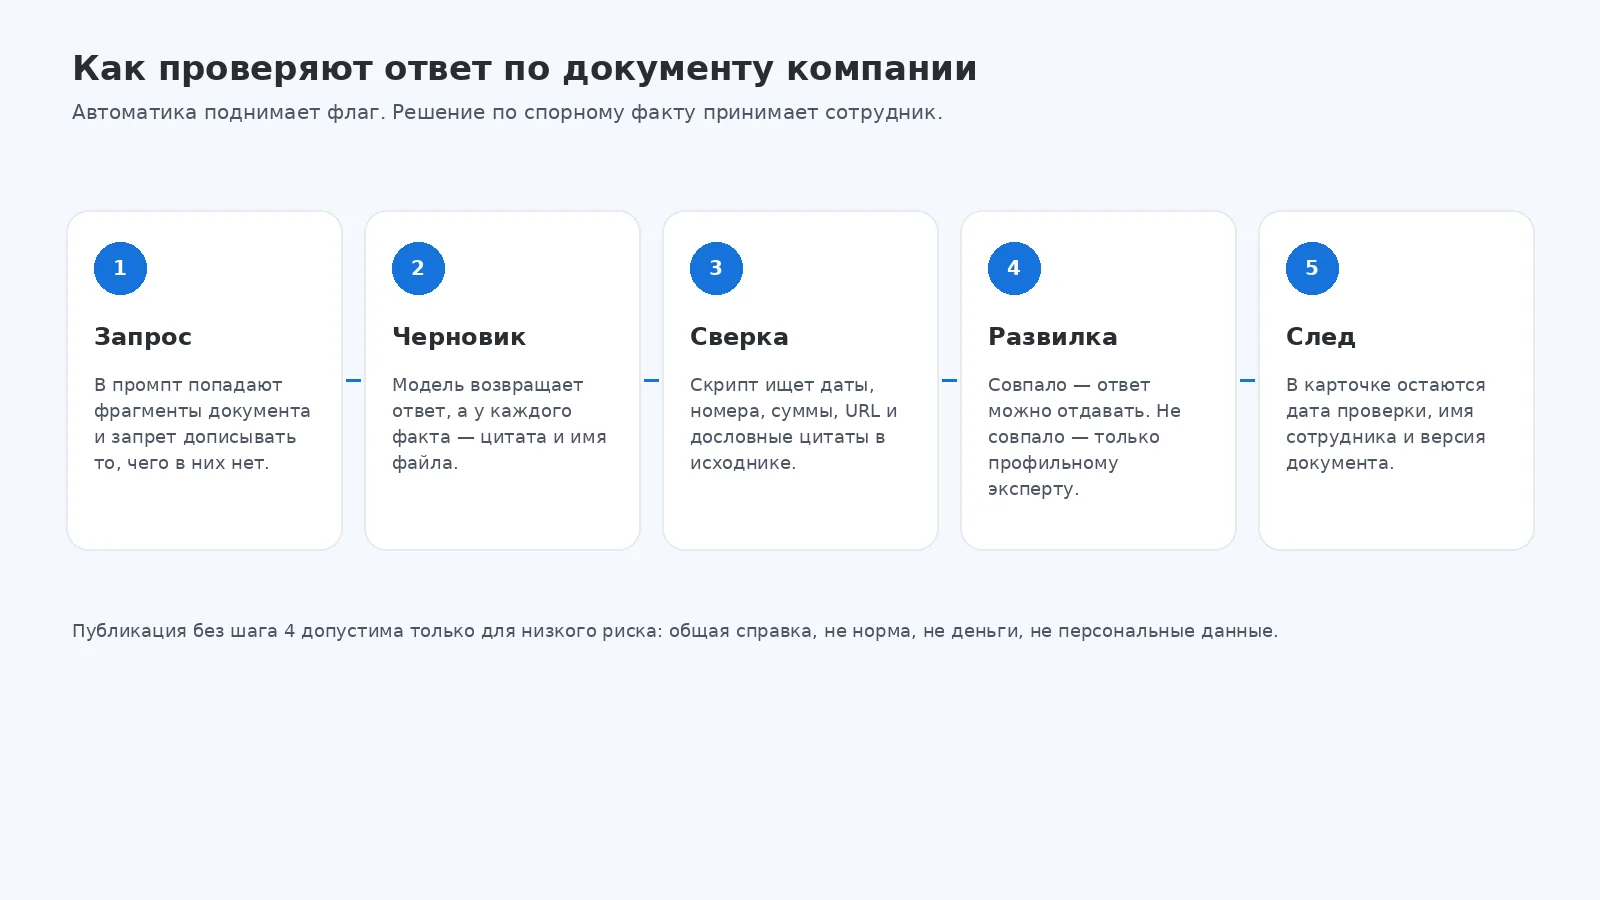
Где ответ нельзя выпускать без человека
Автоматическая сверка поднимает флаг. В части тем флага недостаточно: ответ не должен уходить клиенту, в документ или в решение, пока его не подтвердил профильный сотрудник. Поля заранее делят на высокий, средний и низкий риск и для высокого риска ставят ручную проверку до публикации.
- Юридические тексты. Законы, договоры, судебная практика, внутренние положения. Выдуманная статья или несуществующий прецедент — это риск претензии и санкции. Для юридических организаций галлюцинация — прямой риск нарушения норм. Такой ответ читает юрист, а нормативные формулировки сверяют дословно.
- Медицина. Назначения, дозировки, диагнозы, названия препаратов. Название и дозу можно сопоставить со справочником, но итог подтверждает врач. Ошибка здесь бьёт по правам пациента, а не по «качеству текста».
- Финансы. Выручка, ставки, лимиты, инвестиционные формулировки, цифры отчётности. Неверное число даёт убыток или претензию регулятора. Проценты, валюты и суммы сверяет экономист или аудитор, а не только скрипт.
- Персональные данные. Сведения о сотрудниках и клиентах. 152-ФЗ требует, чтобы персональные данные были точными и актуальными. Подмена поля или «достройка» пустой анкеты моделью этот принцип ломает. Обработка таких сведений идёт под контролем ответственного сотрудника.
- Конфиденциальное и стратегическое. Ноу-хау, внутренние политики, планы. Даже небольшая подмена смысла вредит решению. Такой текст смотрит руководитель направления или профильный эксперт, не один только автор запроса.
Низкий риск — общая справка, черновик структуры, пересказ уже проверенного фрагмента для внутреннего чтения. Его всё равно прогоняют через автоматические проверки, но отдельный эксперт на каждую фразу не обязателен.
Чек-лист перед тем, как ответ уйдёт дальше
Минимум для критичного сценария. Что можно автоматизировать — автоматизируют. Последний просмотр спорных пунктов остаётся за человеком.
- Формат. Ответ пришёл в оговорённой структуре: JSON, таблица, список полей. Свободный абзац хуже поддаётся сверке.
- Сущности. Из текста забраны числа, даты, номера законов и договоров, ИНН и ОГРН, имена, проценты, валюты, URL.
- Ссылки. Каждый URL отвечает кодом 200, а в теле страницы есть ожидаемый якорь: название организации, номер акта, заголовок документа.
- Цитаты. Фрагмент, который модель выдала за цитату, находится в исходном файле. Сравнение идёт по тексту, с допуском только на пробелы и переносы, не на пересказ.
- Свежесть. Дата в ответе не относится к отменённой редакции. Событие и норма сопоставлены с действующей версией документа и с сегодняшней датой.
- Цифры и даты вручную. Каждое число, от которого зависит решение, сверяет тот, кто отвечает за учёт или расчёт.
- Нормы вручную. Каждое упоминание закона, стандарта и «типовой» формулировки читает юрист или владелец регламента.
- Имена. Человек и организация существуют, роль указана верно. Ошибка в имени часто и есть выдумка, а не опечатка.
- Логика. Внутри ответа нет взаимоисключающих утверждений: одно и то же значение не может одновременно расти и падать.
- Версия. На результате стоят дата проверки и имя ответственного. Источники, от которых зависит ответ, поставлены на повторную сверку, когда меняется редакция.
- Исправление. Если ответ уже ушёл с ошибкой, фиксируют дату правки и что именно изменилось. Для публичного текста это та же дисциплина, что у корректурной пометки.
- Эскалация. Несовпадение на автоматической проверке создаёт задачу профильному специалисту, а не «ещё одну генерацию в надежде, что повезёт».
Короткая формула чек-листа: у каждого утверждения есть источник. Нет источника — ответ не отправляют.
Чем проверять: модель, RAG, правила и человек
Одного слоя мало. Рабочая схема складывается из быстрых шаблонов, проверки второй моделью и ручного разбора того, что шаблоны пометили. Ниже — что каждый слой реально ловит.
| Метод | Как работает | Где силён | Где ломается |
|---|---|---|---|
| Вторая модель как фильтр | Оценивает, опирается ли тезис на переданный фрагмент | Смысловые перекосы, которые не ловит регулярное выражение | Дорого, медленно; модели могут повторить одну ошибку. Сервисы вроде Braintrust закрывают прогон таких оценок, но не снимают сверку с источником |
| RAG и RAG-триада | Ответ собирается по найденным фрагментам и оценивается по трём осям: релевантность контекста, обоснованность, полнота | Видно, есть ли у тезиса опора в корпусе | Нужны индекс и его обновление. Логическое противоречие и неверная арифметика могут остаться при «хорошей» опоре на текст |
| Шаблоны и разбор сущностей | Числа, даты, ИНН, номера, URL проверяются программой | Быстро и предсказуемо на счетах, актах, карточках | Ломается на нетипичном формате и не понимает, верный ли смысл у верного числа |
| Формальные правила | Для поля задано условие: диапазон, ссылка на справочник, логическое ограничение. Такой подход есть в Automated Reasoning у Amazon Bedrock Guardrails | AWS заявляет точность верификации до 99% на задачах, где правила заданы явно | Правила пишут вручную. Метод узкий: структурированные поля и политики, не свободный абзац |
| Внешние фактчекеры | FactCC, ClaimBuster, Google Fact Check Explorer, Snopes сверяют тезис с публичными базами | Массовые публичные утверждения | Внутренний договор, регламент и учётная цифра туда не попадают |
| Эксперт | Спорные пункты читает юрист, врач, финансист или владелец процесса | Самая высокая достоверность и понимание контекста | Дорого и не масштабируется на каждый черновик. Поэтому эксперт видит флаги, а не весь поток |
Иногда тот же вопрос задают трём разным моделям и смотрят расхождение. Если ответы разъехались, это сигнал к проверке, а не голосование большинством. Время и счёт за запросы вырастают примерно втрое, поэтому приём оставляют для запросов с высоким риском.
Как устроен сам поиск фрагментов по внутренним документам — в разборе RAG. Доступ модели к учётной системе без выгрузки базы наружу — в статье про MCP-серверы для 1С.
Пять типов галлюцинаций
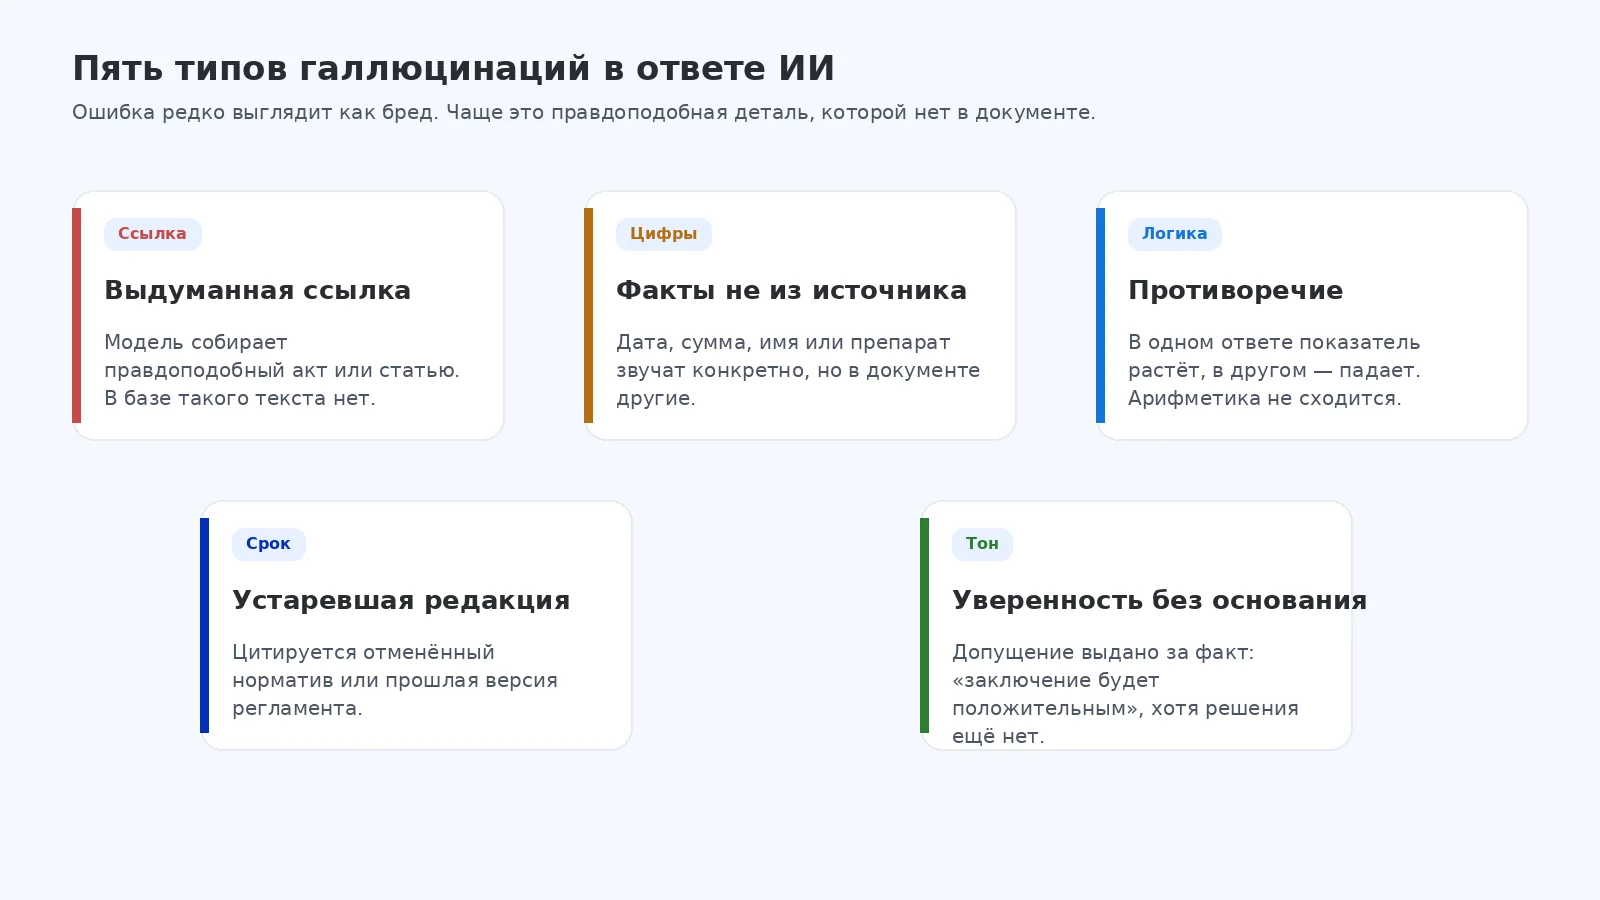
- Выдуманная ссылка или цитата. Модель собирает правдоподобный реквизит. Образец такой выдумки, а не реального акта: «Постановление Правительства № 256-ФЗ от 15.03.2015». Постановления правительства не нумеруются как федеральные законы, и этого документа нет. На глаз реквизит выглядит аккуратно, расхождение находится только сверкой с базой.
- Факты не из источника. Неверная дата вступления нормы, чужая сумма, имя человека, которого в деле нет, название препарата, которого не существует. Расхождение видно, как только значение ищут в исходном файле или справочнике.
- Противоречие внутри ответа. В тексте «рост на 20%», в таблице по тому же показателю «снижение на 5%». Или выручка в выводе растёт, а в строках отчёта падает. Это ловится разбором всех числовых утверждений и проверкой, что они не исключают друг друга.
- Устаревшая редакция. Модель ссылается на норму 2012 года там, где действует редакция 2024 года, или на документ, который уже отменён. Признак — дата и контекст вне актуального периода. Сверка идёт с действующей версией, а не с первой найденной.
- Уверенность без основания. Допущение выдано за факт: «заключение будет положительным», хотя лицензия ещё не получена и в документах решения нет. Здесь нужен человек: скрипт не всегда отличает прогноз от свершившегося события, если оба звучат утвердительно.
Опасный случай — не абсурд, а склейка настоящих фрагментов. Каждая цитата по отдельности есть в корпусе, а вывод из них модель достроила сама. Поэтому в чек-листе отдельно стоят и дословность цитаты, и логика всего ответа.
Пошаговая проверка
- Генерация. Запрос на русском, рядом — фрагменты документа компании, лучше через RAG, а не «ответь из общих знаний». В промпте прямо сказано: не добавляй сведений, которых нет в переданных фрагментах, и на каждый факт верни ссылку на файл и цитату.
- Автопроверка. Шаблоны и распознавание сущностей забирают факты. Поиск по корпусу проверяет, что они есть в документах. Параллельно можно спросить вторую модель про обоснованность. Если всплыли цитата или реквизит, которых в базе нет, задача сразу помечается на эскалацию.
- Эксперт. При высоком риске или при флаге ответ читает назначенный сотрудник: слова, цифры, нормы. Он либо подтверждает текст, либо возвращает его на правку. У блока есть владелец, иначе флаг висит без адресата.
- Правка и запись. Неверный ответ не «чуть-чуть догенерируют» втихую. Либо уточняют запрос и получают новый черновик, либо пишут ответ сами. В журнале остаются дата, имя и что изменилось. Это нужно для аудита, а не для отчёта ради отчёта.
- Эскалация. Если сотрудник сам не уверен или видит серьёзный разъезд с документом, вопрос уходит выше — руководителю юридического блока, главному бухгалтеру, врачу, владельцу регламента. Для этого хватает короткого письма по шаблону ниже.
Периодически имеет смысл выборочно перечитывать уже одобренные ответы, а не только новые. Источники меняются, и вчерашняя верная цитата сегодня указывает на отменённую редакцию.
Письмо, если факт в документе не нашёлся
Письмо короткое: что спросили, чего нет в корпусе, что нужно подтвердить по первоисточнику. Адресат сам решает, ошибка это модели или пробел в базе.
Тема: Нужно подтвердить данные в ответе ИИ
Добрый день!
В ответе ассистента на запрос «[суть вопроса]» есть сведения, которых нет в наших документах. Он ссылается на [например: ст. 15 закона, которого нет в переданном тексте] и указывает [например: 20%], хотя в исходнике этого значения нет.
Проверьте, пожалуйста, существует ли такая норма или цифра. Если это ошибка модели, пришлите формулировку из первоисточника. Иначе мы отдадим клиенту неверный факт.
Спасибо.
[Имя, должность, отдел]
Матрица рисков
«Критично» значит: ответ блокируют и сразу зовут эксперта. «Высокий» — тщательная проверка до отправки. «Средний» — обычная сверка по чек-листу. «Низкий» — обычно хватает автоматических проверок.
| Тип ошибки | Юриспруденция | Медицина | Финансы | Обычные внутренние тексты |
|---|---|---|---|---|
| Выдуманная ссылка или цитата | Критично. Проверяет юрист, в выдачу не пропускают | Высокий. Ссылки на протоколы и инструкции пересматривает врач | Средний. Реквизиты и источники смотрят аудит или методолог | Низкий или средний. Достаточно сверки редактором |
| Цифры и имена не из источника | Критично. ФИО, сроки, суммы статей | Критично. Любое медицинское значение | Высокий. Перекрёстная сверка с учётом | Низкий. Обычно хватает автоматической проверки |
| Противоречие внутри ответа | Высокий. Текст читают целиком | Высокий. Риск неверного вывода, смотрит врач | Высокий. Смотрит бухгалтер или финансовый аналитик | Средний. Смотрит редактор |
| Устаревшая редакция | Высокий. Базу актов обновляют постоянно | Высокий. Следят за актуальными инструкциями и перечнями | Средний. Контролируют версию норматива и отчёта | Средний. Стоит слежение за изменениями регламентов |
| Уверенность без основания | Средний. Нет данных — так и пишут, без догадки | Критично. Уровень уверенности обозначает врач | Средний. Экономист даёт диапазон или оговорку, не точку | Низкий. Внутренний просмотр по необходимости |
На каждую критичную клетку назначают роль, а не «отдел в целом». Иначе флаг некому закрыть.
Что снижает риск на практике:
- в юриспруденции и медицине финальную отметку ставит человек соответствующей квалификации;
- на критичных полях работают и автоматические проверки согласованности, и формальные правила — например, процент не может быть выше 100, если поле это запрещает;
- источники обновляются по фиду или API, а не «когда-нибудь перечитаем папку»;
- в договоре с подрядчиком прямо написано, что модель может ошибаться, а ответы по нормативам и деньгам проверяет заказчик; одна только оговорка ответственность не снимает, но убирает иллюзию, что генерация равна заключению;
- раз в период выборочно перечитывают уже принятые ответы.
Что поставить вокруг проверки
Сверка цитат не заменяет контур, в котором документы вообще не уезжают наружу. Поиск по внутренним файлам собирают как RAG, изоляцию без исходящего канала — как закрытый контур, а локальную модель на сервере заказчика — как услугу on-premise. Готовность процессов до пилота удобно прогнать по чек-листу руководителя.
Если модель должна не только ответить, но и сделать шаги в учётной системе, это уже агент: у него те же галлюцинации плюс риск действия. Как устроены такие системы и из чего складывается стоимость, разобрано в статье про ИИ-агентов для бизнеса и на странице разработки ИИ-агентов.
Отдельный сценарий — пакет договора контрагента, риски с цитатой и протокол разногласий. Его не закрывают общим фактчекингом ответа: для этого есть YasnoDoc. Юрист по-прежнему правит формулировки сам.
Роботок собирает проверку вместе с поиском по документам в контуре заказчика: модель видит ваши файлы, спорный факт не уходит клиенту без владельца процесса, а данные не кладутся в чужой чат. Если нужно разобрать конкретный поток — договоры, поддержка, внутренние регламенты — оставьте заявку, посмотрим документы и риск, а не «чат вообще».


