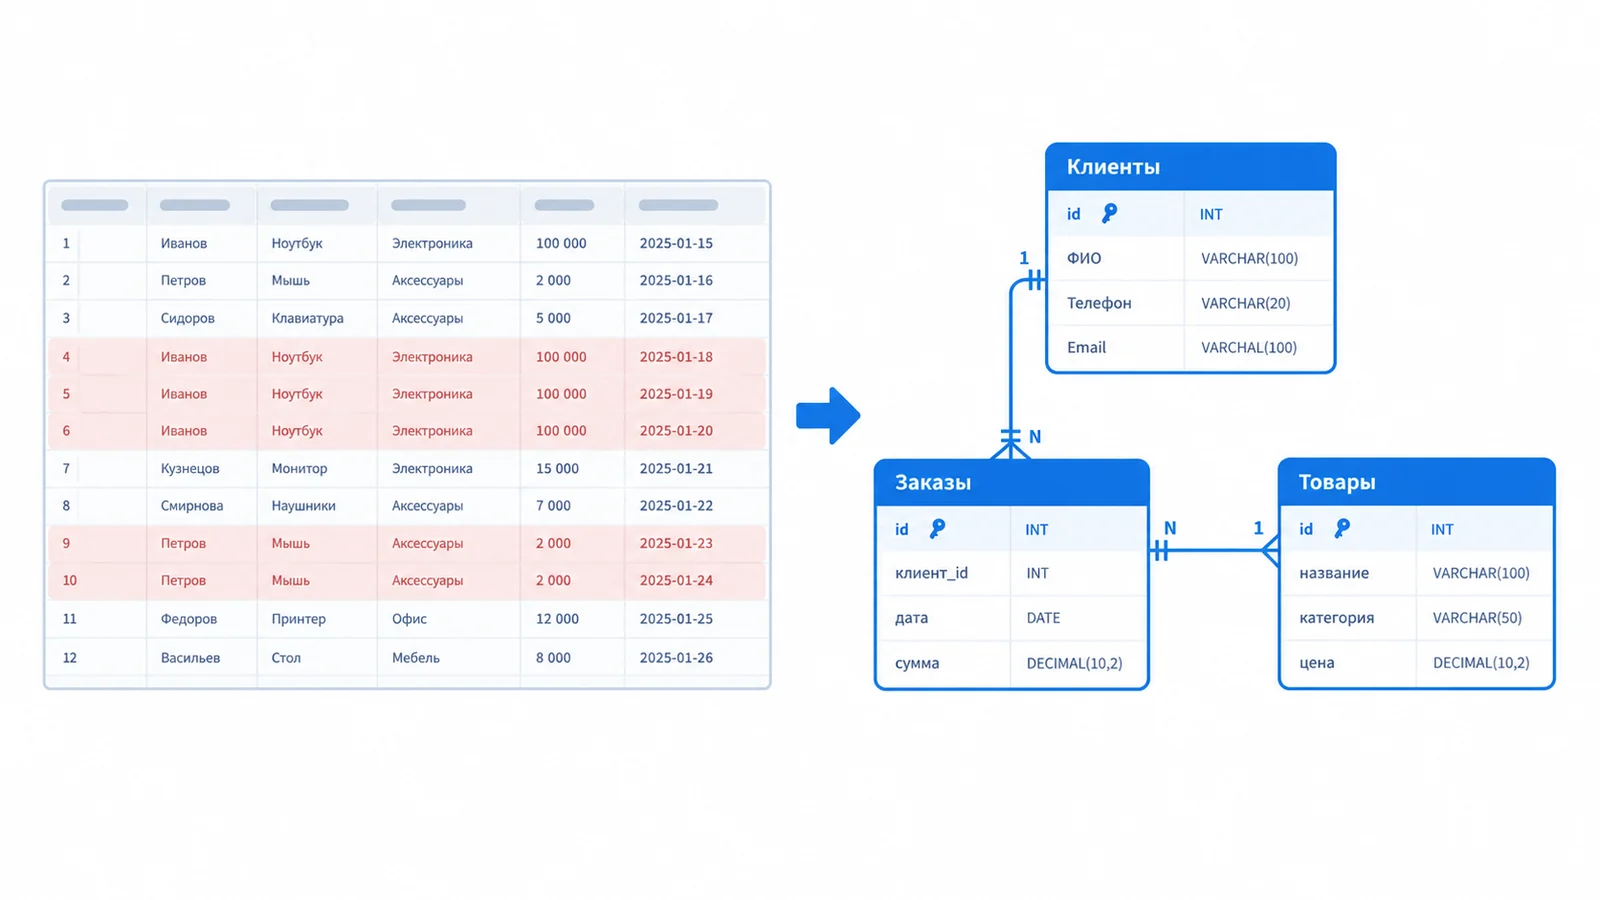
Нормализация данных — это процесс преобразования структуры реляционной базы данных для устранения избыточности и аномалий вставки, обновления и удаления. Цель — минимизировать дублирование данных и гарантировать целостность. Нормальные формы (1НФ, 2НФ, 3НФ, БКНФ) задают формальные условия качества схемы: каждая устраняет свои типы зависимостей и аномалий. Денормализация, наоборот, вводит контролируемую избыточность для ускорения чтения — за счёт худшего времени записи.
Ниже — назначение нормализации и аномалии, формальные определения нормальных форм с примерами, пошаговый разбор нормализации таблицы с SQL-кодом и схемой связей, а также причины, приёмы и компромиссы денормализации. В конце — сравнительная таблица нормальных форм и практические советы для разработчиков и администраторов БД.
Что такое нормализация данных и зачем она нужна
Нормализация данных — это процесс декомпозиции таблиц базы данных с целью устранения логической избыточности и противоречий. Она не направлена на увеличение производительности или экономию места, а на поддержание целостности и удобочитаемости схемы. В частности, нормализация позволяет предотвратить так называемые аномалии данных:
- Аномалия вставки (Insert). Возникает, когда невозможно добавить новую запись без указания лишних данных: например, пока не создан заказ, нельзя завести информацию о товаре.
- Аномалия обновления (Update). Проявляется, если при изменении данных в одном месте не обновляются все копии: например, имя клиента меняется только в одной строке, а в других остаётся старое.
- Аномалия удаления (Delete). Если при удалении записи пропадает также связанная информация. Например, удалили последнего студента из группы — вместе с ним исчезли сведения о самой группе.
Ненормализованные таблицы обычно имеют дублирующиеся столбцы и сложные составные поля, что и приводит к описанным проблемам. Как пишет К. Дейт, общее назначение нормализации — исключение избыточности и устранение аномалий обновления. Проще говоря, нормализация упрощает проект БД и обеспечивает логическую консистентность данных при операциях INSERT/UPDATE/DELETE.
Нормальные формы и функциональные зависимости
Нормальные формы (НФ) вводят строгие требования к схемам отношений. Каждая следующая НФ включает условия предыдущих и добавляет новые ограничения на функциональные зависимости (ФЗ) между столбцами.
Первая нормальная форма (1НФ)
Отношение находится в 1НФ, если все атрибуты атомарны, то есть каждый столбец содержит неделимое значение — никаких списков или множеств. Практически это означает отсутствие повторяющихся групп и подтаблиц внутри одной записи. В терминах реляционной модели таблицы по определению находятся в 1НФ, но на практике в них встречаются неатомарные данные — например, столбец «Товары1, Товары2» или перечисление через запятую. При переходе в 1НФ такие многозначные поля устраняются, а данные разбиваются на строки.
Вторая нормальная форма (2НФ)
Отношение в 2НФ, если оно уже в 1НФ и каждый неключевой атрибут функционально полностью зависит от всего потенциального ключа. Иначе говоря, если есть составной ключ, то ни один столбец не должен зависеть только от его части. Это исключает частичные зависимости. Например, в таблице (Заказ, Товар, ИмяКлиента) атрибут ИмяКлиента зависит только от Заказа — части ключа, что нарушает 2НФ. Перенос таких зависимостей в отдельные таблицы путём декомпозиции устраняет дублирование.
Третья нормальная форма (3НФ)
Отношение в 3НФ, если оно в 2НФ и нет транзитивных зависимостей неключевых атрибутов от ключа. Транзитивная зависимость — когда атрибут A → B → C, то есть A определяет B, а B — C. В таблице (Сотрудник, Департамент, Город), если Сотрудник → Департамент и Департамент → Город, то Город транзитивно зависит от Сотрудника. В 3НФ такая ситуация недопустима: нужно вынести зависимые атрибуты в отдельную таблицу — например, выделить таблицу «Департаменты». Таким образом 3НФ устраняет зависимость «ключ → неключ → неключ», улучшая целостность.
Нормальная форма Бойса — Кодда (БКНФ)
Это усиленная 3НФ: отношение в БКНФ, если для каждой нетривиальной ФЗ X → Y детерминант X является надключом — то есть содержит некоторый кандидатный ключ. Иначе говоря, любая зависимость идёт только от ключа. БКНФ устраняет случаи, когда несколько кандидатов на ключ «пересекаются» в зависимостях. На практике 3НФ часто достаточно, но если обнаруживается зависимость, нарушающая БКНФ, требуется дополнительная декомпозиция.
Нормальные формы выше 3НФ (4НФ, 5НФ и так далее) связаны с мультизависимостями и проекционно-соединительными зависимостями; они применяются в очень специфических ситуациях — например, при сложных алгебраических разбиениях. Обычно же задачи OLTP-систем ограничиваются 3НФ и БКНФ.
Пример нормализации: шаг за шагом
Рассмотрим конкретный пример. Пусть изначально есть денормализованная таблица продаж SalesDenorm, где хранятся данные о заказах:
CREATE TABLE SalesDenorm (
    order_id    INT,
    customer    VARCHAR(50),
    city        VARCHAR(50),
    product_id  INT,
    product     VARCHAR(100),
    quantity    INT
);

INSERT INTO SalesDenorm VALUES
  (1, 'Иван', 'Москва', 101, 'Ноутбук', 1),
  (1, 'Иван', 'Москва', 102, 'Монитор', 2),
  (2, 'Пётр', 'СПб',    101, 'Ноутбук', 1);
Здесь ключ таблицы — составной (order_id, product_id). Заметим несколько нарушений: атрибуты customer, city зависят только от order_id, а product — только от product_id. Это частичные зависимости относительно ключа, то есть таблица не находится во 2НФ. Начнём нормализацию.
Шаг 1. 1НФ
Таблица уже в 1НФ — никаких множеств в полях нет. Если бы, например, товары в заказе были записаны через запятую в одном столбце, мы бы вынесли каждую пару (order_id, product) в отдельную строку. Здесь позиции заказа уже разнесены по строкам, так что условие 1НФ выполняется.
Шаг 2. 2НФ
Устраняем частичные зависимости от частей ключа: customer, city зависят только от order_id, а product — только от product_id. Разобьём на три таблицы:
-- Таблица заказов (номер заказа и информация о клиенте)
CREATE TABLE Orders (
    order_id  INT PRIMARY KEY,
    customer  VARCHAR(50),
    city      VARCHAR(50)
);

-- Таблица продуктов (ID продукта и название)
CREATE TABLE Products (
    product_id INT PRIMARY KEY,
    product    VARCHAR(100)
);

-- Таблица «позиции заказа» с количеством
CREATE TABLE OrderItems (
    order_id   INT,
    product_id INT,
    quantity   INT,
    PRIMARY KEY (order_id, product_id),
    FOREIGN KEY (order_id) REFERENCES Orders(order_id),
    FOREIGN KEY (product_id) REFERENCES Products(product_id)
);

-- Заполняем новые таблицы из исходных данных
INSERT INTO Orders (order_id, customer, city)
    SELECT DISTINCT order_id, customer, city FROM SalesDenorm;
INSERT INTO Products (product_id, product)
    SELECT DISTINCT product_id, product FROM SalesDenorm;
INSERT INTO OrderItems (order_id, product_id, quantity)
    SELECT order_id, product_id, quantity FROM SalesDenorm;
В результате таблица OrderItems уже находится во 2НФ: все неключевые атрибуты (quantity) функционально зависят от всего ключа, а зависимые от частей ключа переместились в Orders и Products.
Шаг 3. 3НФ
Проверим транзитивные зависимости. В нашем примере их нет: в таблице Orders ключ — order_id, и customer, city зависят прямо от него; в Products ключ product_id, атрибут product — тоже напрямую. Таким образом каждая таблица уже в 3НФ. Можно дополнительно отметить, что все наши таблицы удовлетворяют и БКНФ, поскольку в них у любой функциональной зависимости левый атрибут — ключ.
Таким образом из одной исходной таблицы мы выделили три, тем самым устранили избыточность данных. Изначально информация о клиенте «Иван, Москва» хранилась дважды — для двух позиций заказа. После нормализации она хранится один раз в таблице Orders.
Схема связей после нормализации: сущность Orders связана с OrderItems типом «один ко многим» (один заказ может иметь много позиций), а Products — с OrderItems также «один ко многим» (каждый товар может входить во многие заказы). Такая структура исключает описанные аномалии.
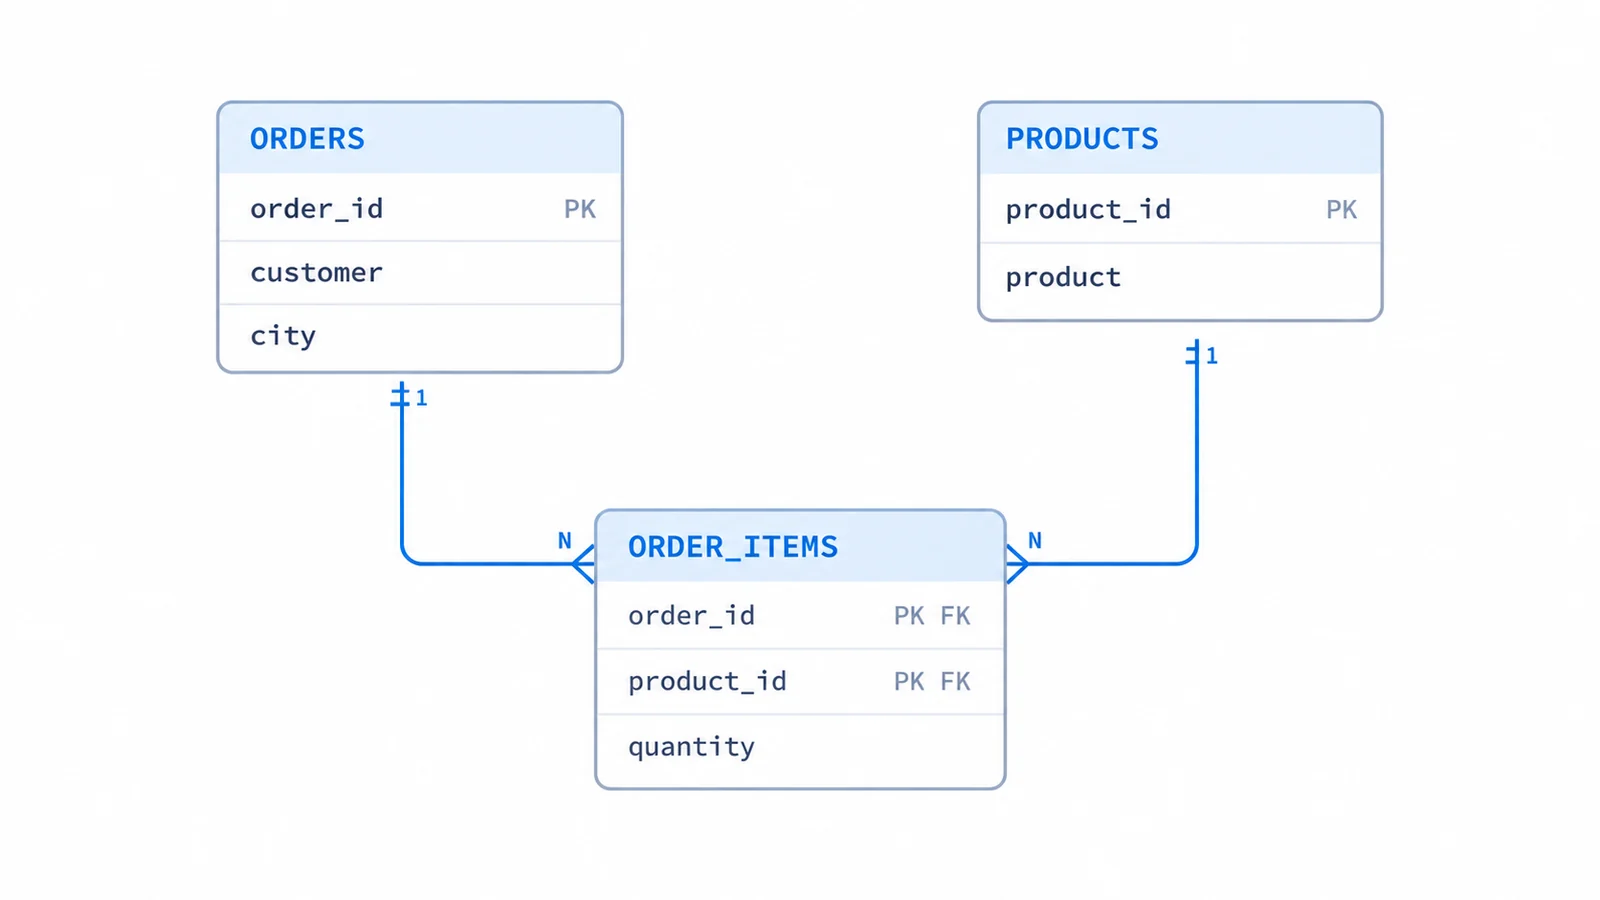
OrderItems связывает заказы и товары составным ключом (order_id, product_id).Денормализация: зачем, когда и как
Денормализация — это осознанное введение избыточности в уже нормализованную схему ради повышения производительности. Когда база данных обслуживает огромное число запросов чтения (BI-платформы, аналитика) и несколько таблиц часто соединяются JOIN, нормализация может замедлить выполнение запросов. Денормализация ускоряет такие запросы за счёт избежания сложных объединений и дополнительных вычислений. Типичные приёмы:
- Дублирование столбцов. Добавление в таблицу столбца, содержащего данные из связанной таблицы — например, сохранить
cityклиента прямо в таблице заказов. - Сохранение агрегатов. Вычисление и хранение промежуточных сумм или статистик: например, столбец
total_amountв заказе вместо расчётаSUM(quantity * price)при каждом запросе. - Объединённые таблицы (снижение числа JOIN). Создание материализованного представления или таблицы, в которой объединены связанные данные. Классический пример — звёздная схема: таблица фактов плюс размерности.
- Предвычисленные выражения. Хранение результата сложных вычислений, используемых во множественных запросах.
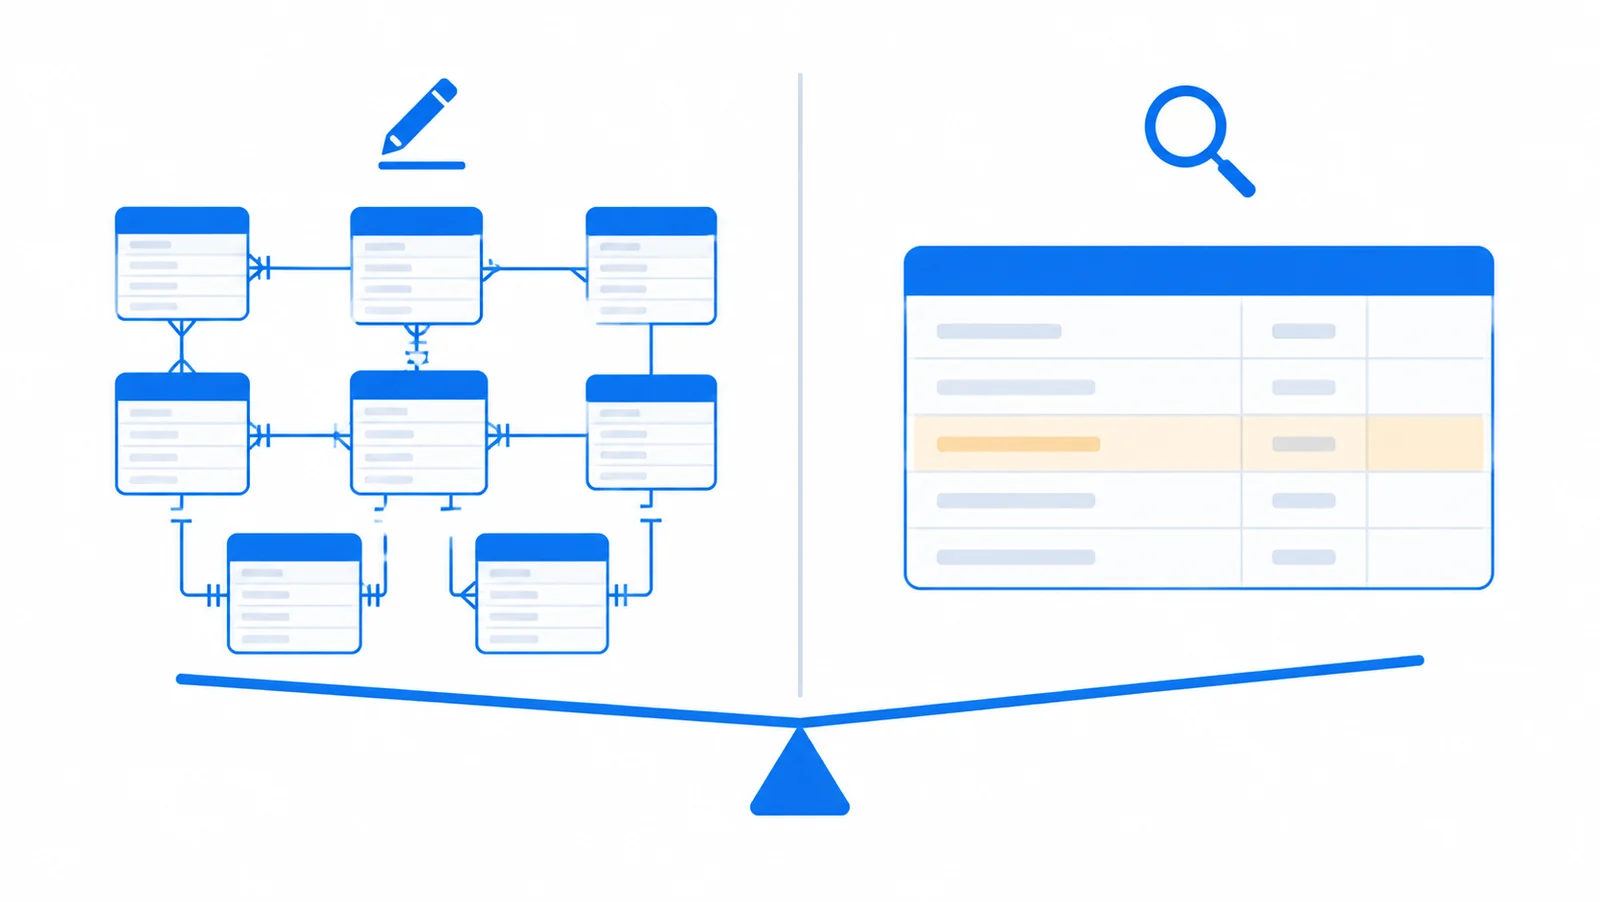
Причиной для денормализации чаще всего является скорость обработки запросов: денормализованные таблицы позволяют избежать нескольких объединений и агрегатных операций, что в ряде СУБД даёт существенный выигрыш в производительности. Однако следует помнить о компромиссах: избыточность усложняет поддержание целостности. Если у вас появились дубликаты данных, при изменении одной копии придётся обновлять все остальные — иначе БД разойдётся. В базе создаются дополнительные ограничения (триггеры, обновляемые представления) на синхронизацию копий, но это увеличивает сложность схемы и замедляет операции INSERT/UPDATE/DELETE.
Пример. Предположим, есть таблица Customers (ID, имя, город) и часто нужно получать число заказов каждого клиента. Можно добавить в Customers столбец order_count, в котором хранится число заказов. Запросы «получить имя клиента и число заказов» станут быстрыми — без объединения с таблицей заказов, — но нужно поддерживать order_count при каждой вставке или удалении заказа. Это классический пример денормализации: выигрыш в чтении ценой усложнённой логики записи.
Итак, денормализация улучшает время ответа SELECT за счёт хранения уже объединённых или агрегированных данных, но увеличивает избыточность. Поэтому она уместна в ситуациях с частыми чтениями большого объёма данных — например, в хранилищах данных и аналитике. Стандартные техники: добавление избыточных столбцов, создание обобщённых таблиц (звёздные схемы), предкомпилированных срезов и кубов. Нужно помнить о компенсационных мерах (constraints, проверки) во избежание рассинхронизации и о том, что современные системы всё чаще жертвуют избыточным хранением ради скорости запросов.
Сравнительная таблица нормальных форм
| Нормальная форма | Основное условие | Устраняет / избегает | Пример эффекта |
|---|---|---|---|
| 1НФ | Каждый атрибут — атомарное (неделимое) значение | Многозначные поля, повторяющиеся группы | Таблица без вложенных списков и подтаблиц |
| 2НФ | В 1НФ + полные зависимости: все неключевые атрибуты полностью зависят от ключа | Частичные зависимости от части ключа | Перенос данных о клиенте в отдельную таблицу заказов |
| 3НФ | В 2НФ + отсутствуют транзитивные зависимости | Транзитивные зависимости (ключ → A → B) | Выделение таблицы «Департаменты» вместо колонки в таблице «Сотрудники» |
| БКНФ | Для любой ФЗ X → Y левый атрибут X — надключ (содержит ключ) | Любые зависимости от неключей (строже 3НФ) | Гарантия, что каждая зависимость идёт от ключа |
Каждая следующая форма полностью включает требования предыдущих и накладывает новые. Например, если таблица в 3НФ, она автоматически в 1НФ и 2НФ. Сравнение: 1НФ требует атомарности, 2НФ — устранения частичных зависимостей (бывает важна при составных ключах), 3НФ — устранения транзитивности, а БКНФ как самая строгая форма требует, чтобы все функциональные зависимости «исходили» от ключа. На практике реляционные схемы проектируются обычно до 3НФ или БКНФ, что обеспечивает отсутствие основных аномалий.
Нормализация в анализе данных и машинном обучении
Тем же словом называют принципиально другую операцию: приведение числовых признаков к общему масштабу. Структура данных при этом не меняется — меняются значения. Цель — чтобы алгоритм не считал «выручку в рублях» важнее «количества обращений» просто из-за порядка чисел.
- Min-max нормализация:
x' = (x − min) / (max − min)— приводит значения к диапазону [0; 1]. Чувствительна к выбросам: один аномальный максимум сжимает остальную выборку. - Z-оценка (стандартизация):
z = (x − μ) / σ— среднее 0, стандартное отклонение 1. Диапазон не ограничен, зато устойчивее к выбросам. - Robust scaling:
x' = (x − median) / IQR— на медиане и межквартильном размахе, рабочий вариант при «грязных» данных. - Логарифмирование:
x' = log(1 + x)— не масштабирование в строгом смысле, но обязательный приём для величин с тяжёлым хвостом: сумм чеков, длительностей.
Масштабирование нужно методам, которые считают расстояние или используют градиентный спуск: KNN, SVM, линейные и логистические модели с регуляризацией, нейросети, PCA, k-means. Решающим деревьям, случайному лесу и градиентному бустингу (CatBoost, XGBoost, LightGBM) оно не нужно — они работают с порядком значений, а не с их масштабом.
Главная ошибка здесь — утечка данных. Параметры преобразования (минимум, максимум, среднее, стандартное отклонение) считают только на обучающей выборке и затем применяют к валидационной и тестовой. Если посчитать их на всём датасете, метрики на валидации окажутся завышенными, а в продакшене модель просядет. Сохранённый scaler — часть артефакта модели, а не разовый шаг в ноутбуке.
Практические советы по нормализации
- Документируйте зависимости. Чётко фиксируйте функциональные зависимости между атрибутами. Перед проектированием сделайте ER-диаграмму, чтобы увидеть ключи и зависимости.
- Начинайте с 3НФ. Стремитесь сразу привести схемы в 3НФ или БКНФ, чтобы избежать базовых аномалий. Проверьте на полноту зависимостей: если видите частичную или транзитивную зависимость, разнесите атрибуты по таблицам.
- Используйте суррогатные ключи. Вместо естественных составных ключей часто проще ввести искусственный автоинкрементный ключ (ID). Это упрощает ссылки и часто помогает при нормализации, особенно в сложных связях.
- Следите за изменениями схемы. При добавлении или удалении столбцов пересматривайте нормализацию: новые атрибуты могут нарушить нормальные формы.
- Балансируйте с производительностью. Нормализация улучшает целостность, но может сделать
JOIN-запросы более дорогими. Профилируйте запросы и при необходимости добавляйте индексы или денормализуйте «горячие» части схемы. В PostgreSQL, например, материализованные представления сами по себе являются формой денормализации. - Проверяйте схемы СУБД. Некоторые СУБД (PostgreSQL, MySQL) неявно ожидают, что таблицы находятся в 1НФ и 2НФ. Убедитесь, что ограничения целостности (PRIMARY KEY, FOREIGN KEY, UNIQUE) определены правильно — они часто выявляют нарушения нормальных форм при попытке вставить «неправильные» данные.
- Минимизируйте NULL и повторяющиеся группы. Если в таблице много полей со значением NULL или с многоуровневыми данными (массивами), рассмотрите нормализацию. Отношения должны быть простыми.
- Учитывайте особенности предметной области. Иногда фактические связи противоречат формальным требованиям: наследование типов (специализация сущностей) или многозначные атрибуты. В таких случаях используйте расширенные модели (например, ДКНФ) или гибридные подходы — но осознавайте последствия.