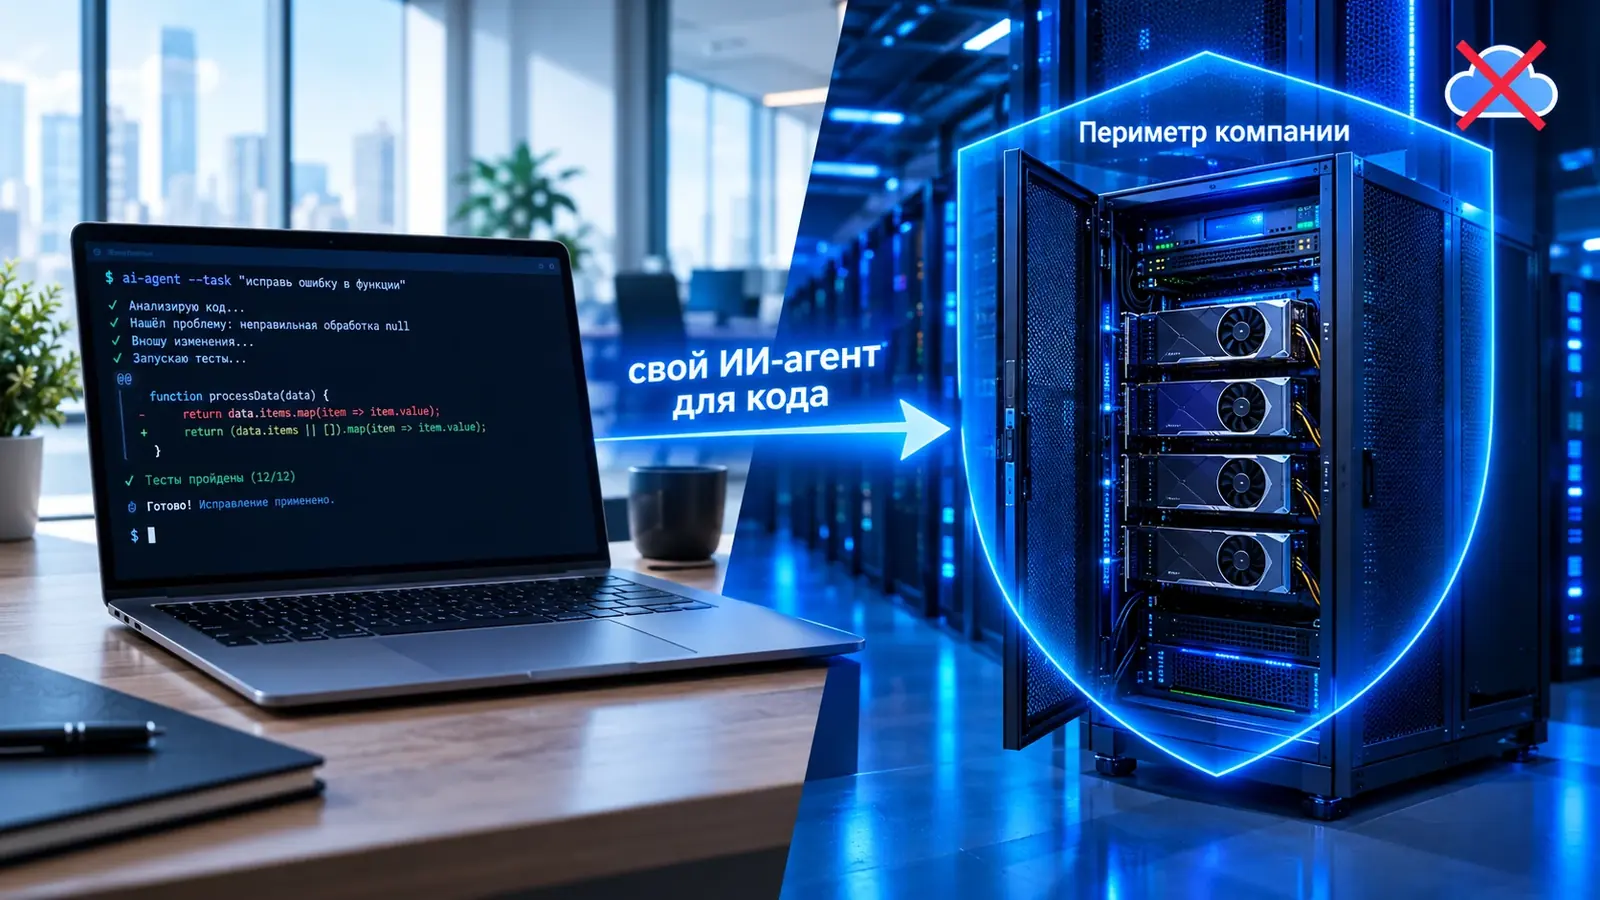
Claude Code от Anthropic и Codex от OpenAI — коммерческие зарубежные ассистенты для написания кода. В российской компании их использование упирается в санкции, требования к хранению данных и внутренние политики информационной безопасности. Поэтому всё чаще смотрят на альтернативы: открытые OpenCode и Qwen Code, которые можно запустить на своём железе, коммерческий GigaCode от Сбера и Codex CLI — клиент OpenAI, у которого модель работает в облаке.
Ниже — правовые и корпоративные риски Claude Code и Codex, сравнение аналогов по лицензии, локальному развёртыванию, API и цене, а затем пошаговая инструкция: как запустить собственного ИИ-агента для кода на базе OpenCode с локальной моделью через Ollama или vLLM.
Короткий ответ
Если исходный код нельзя отправлять за рубеж, начните с OpenCode или Qwen Code: оба распространяются под открытой лицензией и работают с локальной моделью через Ollama или vLLM. GigaCode от Сбера — коммерческий вариант, встроенный в российскую экосистему, но без самостоятельного развёртывания. Прямого федерального запрета на Claude Code и Codex нет, однако из-за санкций, локализации данных и ИБ-политик применять их в компании можно только после тщательной проверки и с внутренним разрешением.
Claude Code и Codex в России: можно ли использовать их в компании
Claude Code (Anthropic) и OpenAI Codex — коммерческие зарубежные продукты, и их использование в российской компании сопряжено с вопросами безопасности и законодательства. С одной стороны, пока нет прямого федерального запрета на использование иностранных ИИ-моделей в бизнесе. С другой — по ряду причин большие риски остаются открытыми.
- Экспортный контроль и санкции. Продвинутые ИИ-модели относятся к «чувствительным технологиям». США ужесточили экспортный контроль и ограничили гражданским лицам доступ к самым мощным моделям — например, Mythos 5 и Fable 5 у Anthropic. Хотя к середине 2026 года многие ограничения сняты, в общем случае доступ к новейшим моделям Anthropic и OpenAI может требовать одобрения по экспортным правилам. Reuters отмечает, что продвинутые модели могут быть недоступны в «неугодных» странах из-за опасений военных злоупотреблений. Формально российское законодательство об экспортном контроле (Федеральный закон № 183-ФЗ «Об экспортном контроле», Таможенный кодекс ЕАЭС) не содержит специальных указаний по ИИ, но международные санкции и требования самих компаний (например, политика OpenAI) могут фактически закрывать доступ.
- Персональные данные и локализация. Российские компании, особенно с иностранным бизнесом или госзаказом, тщательно контролируют передачу данных. Claude Code и Codex работают через API в облаке Anthropic и OpenAI, то есть исходный код или внутренние данные могут уходить на серверы за рубежом. Это ставит под вопрос выполнение 152-ФЗ «О персональных данных» и закона 242-ФЗ о локализации данных: государственные структуры и компании ограничивают хранение персональных данных на иностранных серверах. Поэтому во многих организациях вводить кодовые запросы в Claude или Codex без тщательного анализа рисков запрещено, хотя единого правила на этот счёт нет. Как такие утечки случаются на практике — в разборе утечки данных через ChatGPT и Shadow AI.
- Корпоративная политика. Многие ИТ-компании и банки ввели строгие правила использования внешних генеративных ИИ. GigaCode, например, подчёркивает ориентацию на требования безопасности и контроля при интеграции ИИ-агента в инфраструктуру. Службы безопасности часто запрещают публичные сервисы вроде ChatGPT и Codex из-за риска утечки исходного кода. Даже если прямого запрета нет, внедрение рекомендуется согласовать с юристами и службой ИБ: NDA, внутренние прокси и т. п.
- Лицензирование. У Claude Code и Codex нет локальных on-premise-версий: это сервисы, для которых нужно покупать подписку. OpenAI Codex CLI — лишь клиент, основная вычислительная мощность идёт через облако ChatGPT, поэтому лицензионно это услуга OpenAI. Если компания планирует долгосрочное использование, придётся учитывать коммерческие условия OpenAI и Anthropic: цены, поддержку, изменения политики. Условия использования содержат требования о соблюдении экспортных законов, включая санкции, и прав на интеллектуальную собственность. Если что-то неясно, изучите контрактные условия при конкретной закупке.
Итог. Прямых юридических запретов на использование Claude Code и Codex в России пока нет. Но из-за риска нарушить санкции, требования к локализации данных и корпоративные ИБ-политики применять их в российской компании можно только после тщательной проверки и, скорее всего, с обязательным внутренним разрешением — а на практике это часто означает отказ. В условиях неопределённости крупные предприятия обычно выбирают локальные альтернативы.
Сравнение аналогов: OpenCode, Qwen Code, GigaCode, Codex CLI
Ниже — ключевые характеристики популярных ИИ-агентов для написания кода. Особое внимание уделено условиям использования в России: лицензии, возможности локального развёртывания и соответствию требованиям безопасности.
Разработчик, модели и лицензия
| Инструмент | Разработчик | Семейство моделей | Лицензия |
|---|---|---|---|
| OpenCode | anomaly (open-source) | Любые модели: OpenAI, Claude, локальные | MIT (открытая) |
| Qwen Code | QwenLM (Alibaba) | Qwen, разные варианты 3B–20B | Apache-2.0 (открытая) |
| GigaCode | Сбер (GitVerse) | GLM, Kimi, DeepSeek, Qwen и др. | Проприетарная |
| Codex CLI | OpenAI | Семейство GPT/Codex: Codex, GPT-4 | Apache-2.0 (открытая) |
Локальный запуск, API и цена
| Инструмент | On-premise | API и облачный доступ | Цена |
|---|---|---|---|
| OpenCode | Да, можно полностью локально | Мультипровайдерный CLI | CLI бесплатен; модель — бесплатная из списка или платный API |
| Qwen Code | Да, через Ollama, vLLM и др. | Да, поддерживает Cloud API Qwen и др. | CLI бесплатен; модели Qwen для локального запуска бесплатны, коммерческие API — платно |
| GigaCode | Нет, работает на своей инфраструктуре | Необщедоступно, интеграция через сервер GigaCode | Платно, лицензия от Сбера или партнёров |
| Codex CLI | Нет: CLI локальный, сама модель — в облаке | Да, через ChatGPT API или Codex API | CLI бесплатен, но нужна платная подписка OpenAI (Business или Enterprise — для высших квот) |
Ключевые выводы
- OpenCode — самый гибкий и приватный вариант: открытая лицензия MIT, локальное выполнение, нет зависимости от внешних сервисов. Модель выбираете вы — например, запускаете Llama или Qwen локально через Ollama или vLLM. У проекта активное сообщество, он быстро обновляется и доступен бесплатно. Минус — производительность и возможности сильно зависят от железа и модели.
- Qwen Code — тоже open-source (Apache-2.0), ориентирован на модели QwenLM и хорошо интегрируется с локальными провайдерами через Ollama и vLLM. Рассчитан прежде всего на китайский стек моделей и позволяет легко заменить OpenAI или Claude на модели Qwen. Плюсы — открытый код и локальное исполнение; минус — ключевые модели могут быть крупнее (MoE) и требуют мощного GPU.
- GigaCode — коммерческое решение Сбера, встроенное в российскую экосистему: требования безопасности, данные в РФ. Есть IDE-плагин, CLI и десктопное приложение, поддерживается множество открытых моделей. Главное ограничение — закрытая система с лицензированием и привязка к инфраструктуре: самостоятельного развёртывания нет. Подойдёт крупным компаниям, готовым к корпоративному SaaS.
- Codex CLI — официальная утилита OpenAI: удобный локальный интерфейс с открытым кодом, но все вычисления идут через облако (ChatGPT). Плюс — доступ к GPT-4 и Codex «из коробки». Минусы — зависимость от интернета, платная подписка и вопросы приватности. Подходит, если компания уже покупает корпоративную подписку OpenAI и готова рисковать данными.
Тенденции для российского бизнеса. Локальные и открытые решения (OpenCode, Qwen Code) дают контроль и не попадают под санкционные риски. Коммерческие (GigaCode) легитимны в корпоративной среде, но требуют бюджета. Зарубежные (Claude Code, Codex) потенциально эффективны, но их использование предполагает обход ограничений, а это создаёт риски.
Как запустить агента на своей модели: OpenCode + Ollama или vLLM
Ниже — пошаговая инструкция по развёртыванию собственного ИИ-агента для кода на базе OpenCode с локальным LLM-сервером: Ollama или vLLM. В ней описаны необходимые ресурсы, конфигурация, примерные команды, меры безопасности и отладка. Пример приведён для Linux (Ubuntu, Red Hat); команды для macOS и Windows аналогичны. Чем Ollama отличается от vLLM и что выбрать под нагрузку, подробно разобрано в статье Ollama vs vLLM.
Шаг 1. Подготовка и установка компонентов
- Системные требования. Для локальной LLM нужно мощное железо. Для небольших моделей (примерно до 4–8B) достаточно GPU с видеопамятью от 10–16 ГБ, для крупных (30–70B) — нескольких GPU или серверов с HBM. Многие модели запускаются и на CPU, но медленно — это вариант для тестов, лучше GPU. Учтите, что модели Qwen и Llama могут потребовать десятки гигабайт ОЗУ; если памяти не хватает, примените квантование или возьмите модель поменьше.
- Docker или виртуальная машина (опционально). LLM-сервер можно изолировать в контейнере. Установите Docker по инструкции на docs.docker.com. Если Docker не используете, ставьте ПО напрямую.
Установка Ollama (если выбран Ollama). Ollama — инструмент для запуска моделей под Windows, macOS и Linux. Скачивание:
curl -fsSL https://ollama.com/install.sh | shИли скачайте бинарный файл с официального сайта и поместите его в PATH. Проверка: команда ollama --version должна вывести версию.
Альтернатива — запустить Docker-образ:
docker pull ollama/ollama
docker run --rm -p 11434:11434 ollama/ollama serve
Это запустит сервер Ollama на порту 11434.
Установка OpenCode. OpenCode CLI ставится официальным скриптом или через пакетные менеджеры:
curl -fsSL https://opencode.ai/v2/install | bashДля macOS и Linux есть варианты brew install anomalyco/tap/opencode-v2 или npm i -g @opencode/cli. После установки станет доступна команда opencode.
Установка vLLM (если выбран vLLM):
# Установим vLLM в Python 3.10+ окружении
python3 -m pip install vllm
Для надёжности рекомендуется использовать uv, но pip тоже сработает. Убедитесь, что есть доступ к GPU (CUDA или ROCm), иначе vLLM придётся настраивать для CPU, а это заметно медленнее.
Шаг 2. Запуск и настройка локальной LLM
Вариант А: Ollama. Сначала загрузите модель. В Ollama есть встроенные модели — Gemma, Kimi, GLM, MiniMax и другие. Для начала загрузите нужную:
# Например, модель Gemma 4 (желательно свежая универсальная модель):
ollama pull gemma4
Для моделей Qwen:
ollama pull qwen2:1.5bСписок доступных моделей покажет ollama list после установки; ещё его можно посмотреть в библиотеке на docs.ollama.com/library. Модели с суффиксом -cloud можно запускать через Ollama Cloud, но для локального запуска лучше брать варианты без этого суффикса.
Запуск сервера Ollama:
ollama serveПо умолчанию сервер запустится на http://localhost:11434. Если Ollama ставили скриптом на Linux или запустили в Docker, сервер уже работает и отдельно запускать его не нужно. Адрес и порт задаются переменной окружения OLLAMA_HOST — флага --port у ollama serve нет. Например, чтобы сервер был доступен с других машин в сети:
OLLAMA_HOST=0.0.0.0:11434 ollama serveАдрес 0.0.0.0 открывает сервер для всей сети, поэтому держите его за межсетевым экраном (см. шаг 5). Проверить работу — список загруженных моделей отдаёт /api/tags, OpenAI-совместимый вариант — /v1/models:
curl http://localhost:11434/api/tagsили
ollama lsКоманда должна показать загруженную модель, например gemma4 или qwen3-coder.
Аппаратные ресурсы. Ollama сам распределяет нагрузку между GPU и CPU. Крупным моделям нужно достаточно памяти: например, Gemma 4 7B требует около 8–16 ГБ видеопамяти. Если ресурсов мало, Ollama может брать модели из «облака»; есть и режим CPU, но он медленнее.
Вариант Б: vLLM. vLLM работает с моделями Hugging Face и сам подтягивает их оттуда — например, Llama 2 Chat (7B) или Qwen2.5:
# Скачать и запустить сервер с Llama 2 7B Chat
vllm serve meta-llama/Llama-2-7b-chat-hf
Репозиторий Llama 2 на Hugging Face закрыт лицензионным соглашением Meta: сначала примите условия на странице модели и передайте токен Hugging Face в переменной окружения HF_TOKEN. При первом запуске модель загрузится с Hugging Face, дальше она кэшируется в ~/.cache/huggingface. Адрес и порт задаются флагами --host и --port, по умолчанию — localhost:8000:
vllm serve meta-llama/Llama-2-7b-chat-hf --host 0.0.0.0 --port 8000- Конфигурация безопасности. По умолчанию vLLM открывает интерфейс без API-ключа, поэтому лучше задать свой ключ:
vllm serve meta-llama/Llama-2-7b-chat-hf --api-key=YOURKEY123. Тогда OpenCode должен будет отправлять этот ключ с каждым запросом. - Настройки инференса. Если модель большая, уменьшите максимальную длину контекста флагом
--max-model-lenи число одновременно обрабатываемых запросов флагом--max-num-seqs— это помогает уместиться в доступную видеопамять. - Проверка. Командами
curl http://localhost:8000/v1/modelsиcurl -X POST http://localhost:8000/v1/chat/completionsможно убедиться, что API отвечает: формат тот же, что у OpenAI API. - Аппаратные ресурсы. vLLM эффективно использует GPU и оптимизации для высокой пропускной способности. Для Llama-7B понадобится около 10–16 ГБ видеопамяти, для Llama-13B — от 20 ГБ; расчётные требования описаны в репозитории модели на Hugging Face.
Шаг 3. Настройка OpenCode для работы с локальной LLM
Создайте файл ~/.config/opencode/opencode.json (на Linux; на Windows — %APPDATA%\opencode\opencode.json) со следующим содержимым. Пример для Ollama:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "ollama/qwen3-coder",
  "provider": {
    "ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama",
      "options": {
        "baseURL": "http://localhost:11434/v1"
      },
      "models": {
        "gemma4": {
          "name": "Gemma 4"
        },
        "qwen3-coder": {
          "name": "Qwen3 Coder"
        }
      }
    }
  }
}- Блок
"provider": {"ollama": {...}}настраивает Ollama. ПутьbaseURLуказывает на ваш локальный сервер, а"models"перечисляет загруженные модели — с теми же именами, что в командахollama. - Поле
"model": "ollama/qwen3-coder"задаёт модель по умолчанию. Укажите ту, которую загрузили, например"ollama/gemma4"или"ollama/qwen2:1.5b". - Ключ
"npm": "@ai-sdk/openai-compatible"сообщает OpenCode, что интерфейс LLM совместим с OpenAI API, — его реализуют и Ollama, и vLLM. - Идентификаторы моделей указывайте в формате
provider/имя, как в JSON, — тогда между ними можно переключаться командами OpenCode:/modelsв TUI или/modelв строке запроса.
Для vLLM конфигурация почти такая же, меняется только провайдер:
"provider": {
  "vllm": {
    "npm": "@ai-sdk/openai-compatible",
    "name": "vLLM",
    "options": {
      "baseURL": "http://localhost:8000/v1"
    },
    "models": {
      "meta-llama/Llama-2-7b-chat-hf": {
        "name": "Llama 2 7B Chat"
      }
    }
  }
},
"model": "vllm/meta-llama/Llama-2-7b-chat-hf"
Шаг 4. Запуск и проверка
- Старт OpenCode. Запустите
opencodeв терминале — откроется TUI-интерфейс. После загрузки нажмитеTab, чтобы выбрать режим (обычноbuild— для полноценного доступа). - Выбор модели. Наберите
/models, чтобы увидеть список моделей из конфига, и выберите нужную, например/model gemma4. - Проверка. Напишите простой запрос, например
/ask Как создать функцию на Python, которая вычисляет факториал?Агент направит запрос в локальную модель, получит ответ и выведет его. - Ошибки. Если OpenCode не видит провайдера или модель, проверьте файл
opencode.jsonи путь~/.config/opencode. Убедитесь также, что Ollama или vLLM запущен и доступен на указанном порту.
Шаг 5. Безопасность и отладка
- Ограничение доступа. Запускайте локальный LLM-сервер в изолированной сети за межсетевым экраном и включайте аутентификацию (
--api-key) — так вы предотвратите несанкционированный доступ. Как строится такой контур целиком, мы разбирали в статье ИИ в закрытом контуре. - Изоляция среды. Удобно работать с Docker-контейнером: например,
docker run -d --name ollama -p 11434:11434 ollama/ollama serveпозволит в любой момент перезапустить или удалить контейнер. С vLLM — так же, если есть образ. - Хранение данных. OpenCode хранит свои данные локально. Модели и логи не отправляются наружу, если не настроено обратное. Всегда проверяйте, нет ли в конфиге «чёрного ящика» — провайдера вроде
openaiс API-ключом, пока вы не готовы работать с облачным сервисом. - Если модель тормозит. Когда модель не отвечает или работает крайне медленно, проверьте потребление памяти. Частая проблема — нехватка видеопамяти: модель выгружается на диск и начинается подкачка. Решения — взять модель поменьше (Llama 3, Qwen 3B вместо Qwen 30B), включить квантование INT8 или FP8 (его поддерживает vLLM) или добавить GPU. В дистрибутивах могут понадобиться дополнительные библиотеки: CUDA, NCCL, Intel oneAPI и др.
- Логи. OpenCode, Ollama и vLLM выводят ошибки в консоль и логи. При сбое смотрите консоль LLM-сервиса и проверьте, доходят ли запросы, — часто помогает прямой
curl. - Обновления. OpenCode, Ollama и vLLM регулярно обновляются. Держите их в актуальном состоянии: новые версии обычно исправляют критичные ошибки.
Как устроена связка
OpenCode работает на машине разработчика и обращается к локальному LLM-серверу — Ollama или vLLM, а тот передаёт запрос модели.
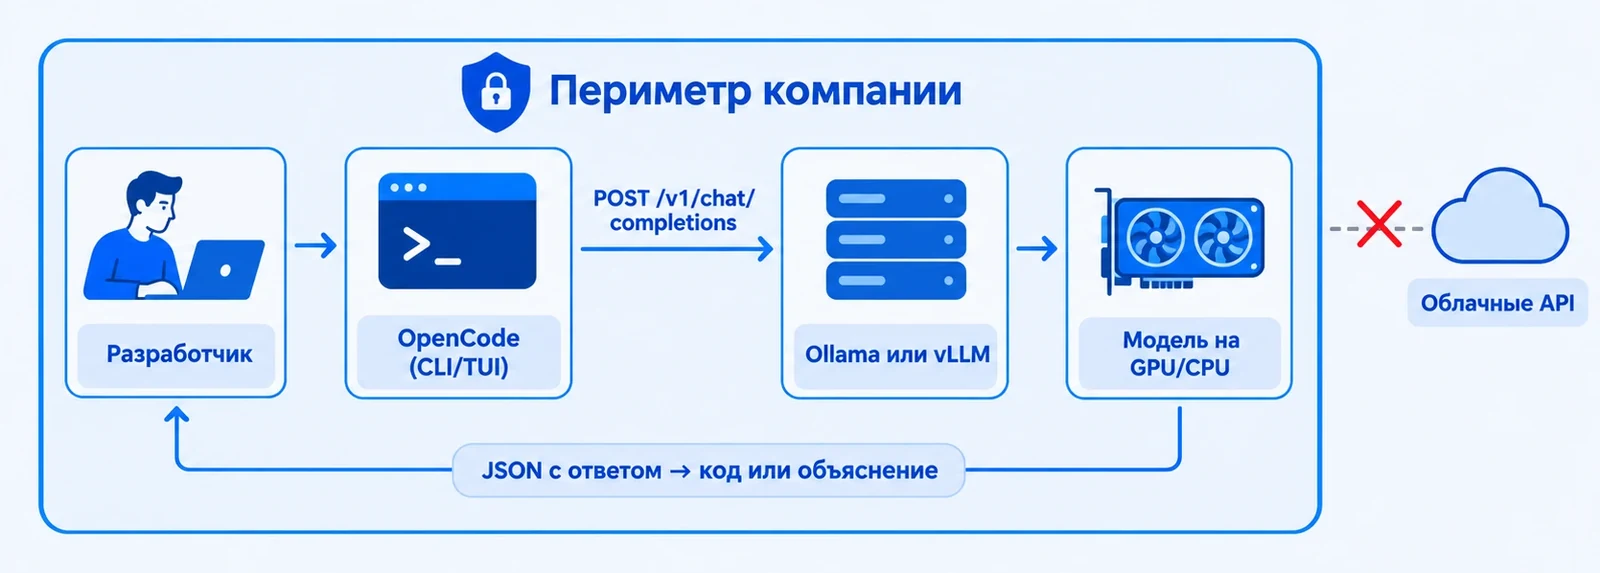
Последовательность такая:
- Разработчик вводит запрос в OpenCode (CLI или TUI).
- OpenCode отправляет HTTP-запрос в формате OpenAI API —
POST /v1/chat/completions— на локальный сервер Ollama или vLLM. - Сервер передаёт запрос нейросетевой модели, которая работает на GPU или CPU в серверной части.
- Модель генерирует ответ, и сервер возвращает его OpenCode в виде JSON.
- Агент выдаёт разработчику код или объяснение.
Что в итоге
Для компании в России выбор агента для программирования сводится к тому, где будет работать модель. OpenCode и Qwen Code с моделью на своём сервере дают контроль и не попадают под санкционные риски. GigaCode закрывает задачу коммерческим продуктом в российской экосистеме, но требует бюджета. Claude Code и Codex без тщательной проверки рисков и внутреннего разрешения использовать не стоит.
Если модель для разработчиков нужно не просто запустить, а встроить в контур компании, начните с выбора между Ollama и vLLM. Как подключить ИИ к корпоративным системам, не отдавая данные наружу, — в разборе MCP-серверов для 1С; общий контекст — в статье что такое ИИ-агент.
Роботок разворачивает локальный ИИ в контуре заказчика — от подбора железа и модели до сопровождения. Обсудить задачу можно на странице внедрения ИИ on-premise.
Источники
- OpenCode — официальная документация: opencode.ai.
- Qwen Code — репозиторий: github.com/QwenLM/qwen-code.
- Codex CLI — репозиторий: github.com/openai/codex.
- Ollama — ollama.com.
- vLLM — github.com/vllm-project/vllm.
- Пресс-релизы и обзоры GigaCode от Сбера, материалы Reuters об экспортном контроле ИИ.